
 魏金华
1. Youtu-Parsing模型概述:多模态文档解析的新范式
在金融、法律、医疗等行业中,每天需要处理海量的PDF合同、扫描票据和结构化报表。传统OCR技术就像"打字员",只能机械地识别文字,却无法理解表格结构、公式含义或文档版式。这正是Youtu-Parsing-2.5B要解决的核心问题——让AI像人类一样"读懂"复杂文档。
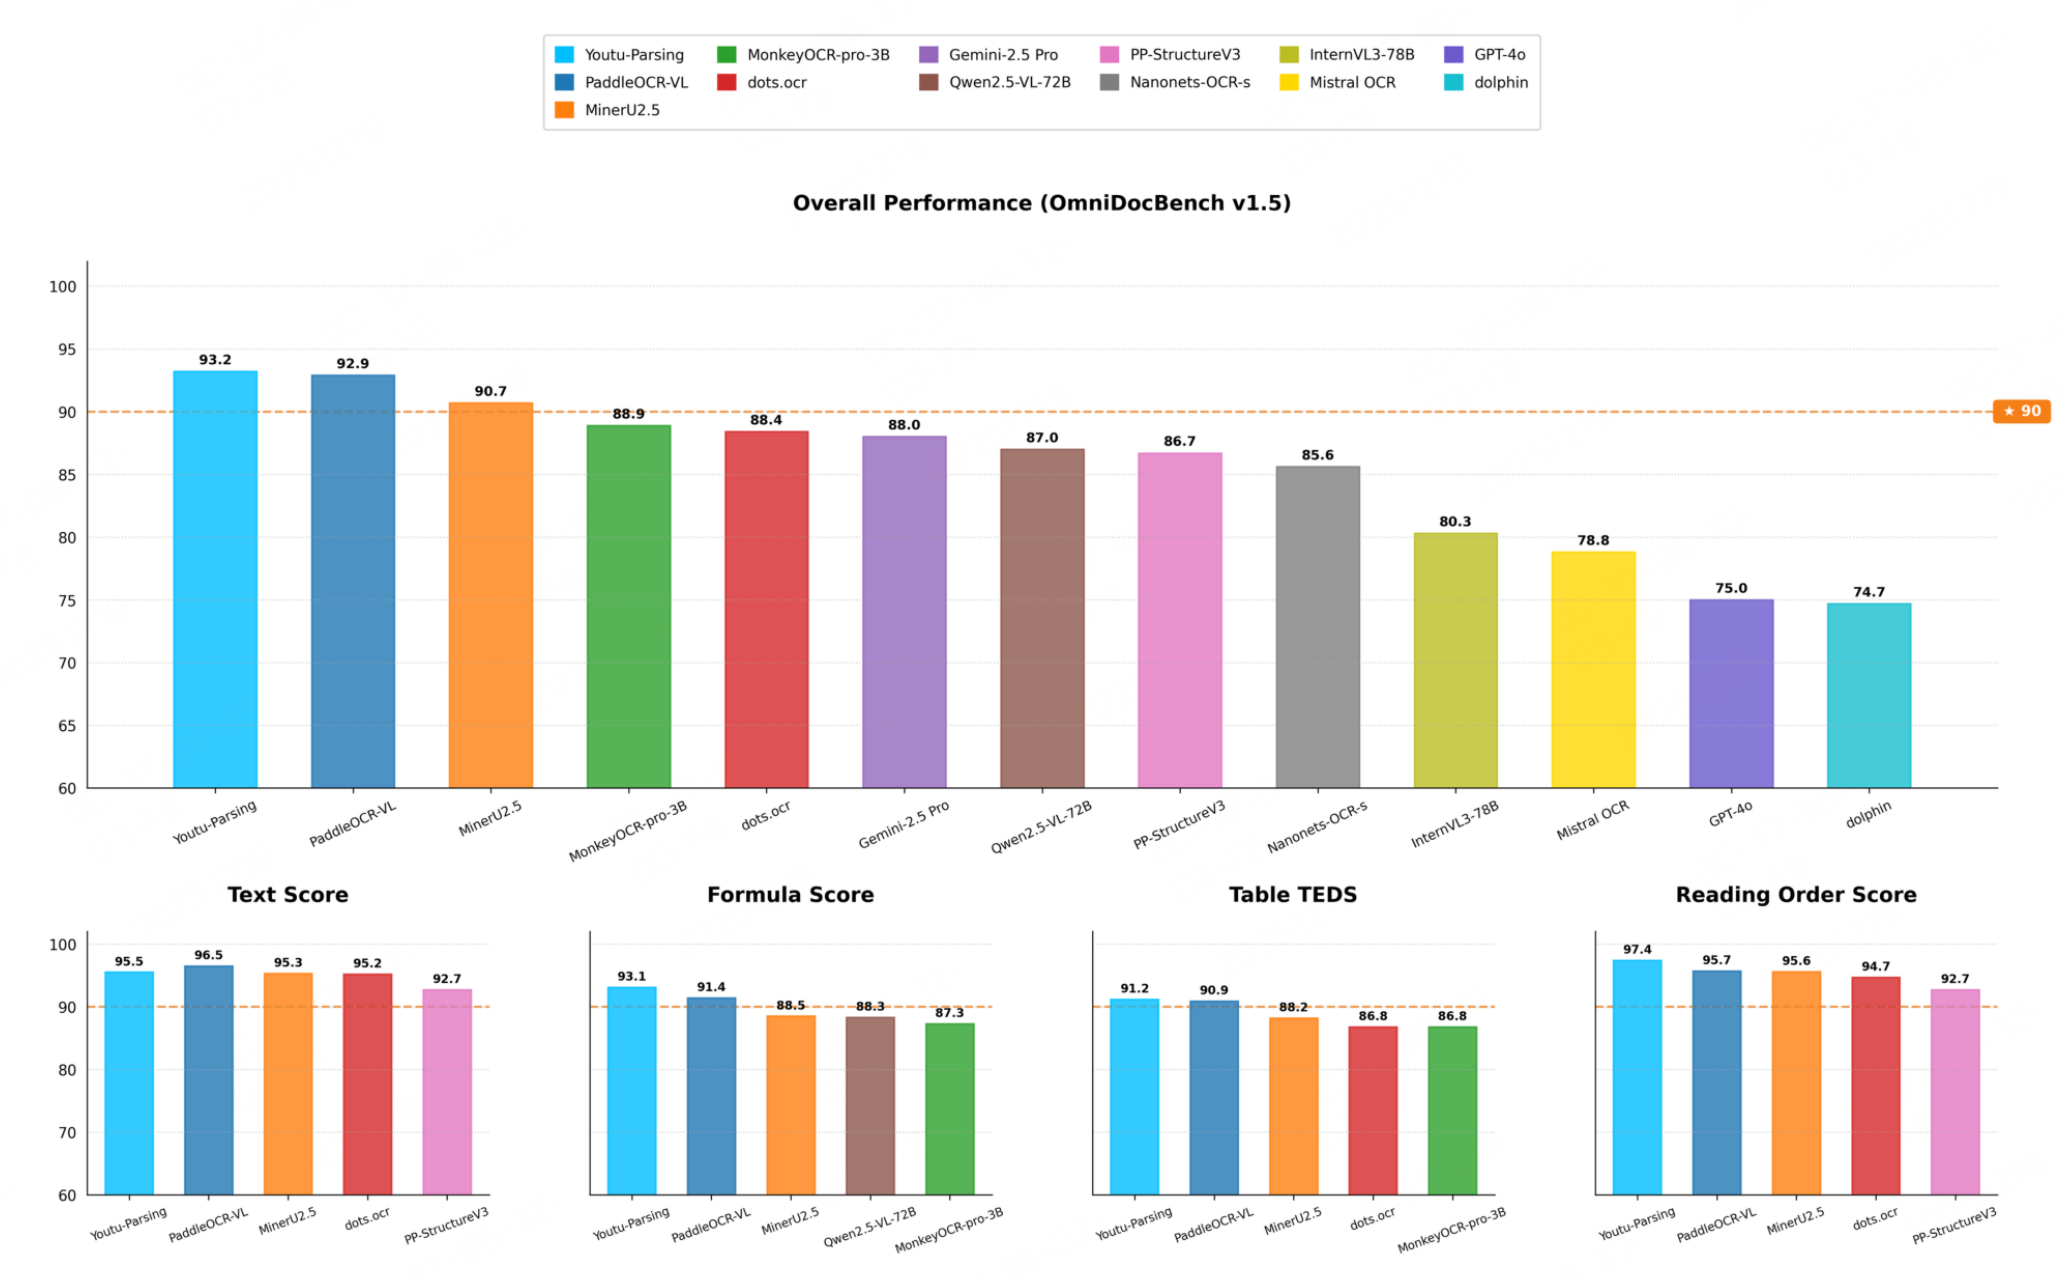
这个开源模型采用多模态视觉语言模型(VLM)架构,创造性地将文档解析分解为三个智能阶段:首先用ViT编码器"扫描"整页文档(类似人眼的全局观察),然后通过LLM分析各元素布局(如区分表格和正文),最后针对不同区域智能选择识别策略(如表格转OTSL格式、公式转LaTeX)。这种模块化设计使得模型在OmniDocBench v1.5基准测试中,相比传统方法提升23%的F1值,同时推理速度加快1.8倍。
关键突破:通过"token级并行+区域级并行"的协同策略,解决了传统自回归解码在长文档处理中的效率瓶颈。实测显示,处理20页学术论文时,延迟从原来的47秒降至11秒。
1.1 传统文档解析的痛点分析
当前主流方案面临两个结构性难题:
序列生成效率低下:就像用老式打字机逐字输入,传统模型生成每个token(字符/符号)都需要完整走一遍推理流程。处理一个包含300个token的表格时,需要进行300次序列生成操作,导致GPU利用率长期低于30%。
多区域处理冗余:现有方法处理文档中的不同元素(文本块、表格、公式)时,往往需要分别调用模型。这就好比让同一个专家反复进出会议室——每次处理新区域都要重新加载视觉特征,造成约40%的计算资源浪费。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 核心技术解析:高并行解码策略
2.1 Token级并行解码机制
模型创新性地引入
- 输入构造:在已有上下文序列后追加64个特殊
token - 并行预测:单次前向传播同时预测所有mask位置的候选token
- 验证筛选:通过语言模型置