
 Cyst
1. 从零认识LLM Agent:智能体的本质与价值
第一次听说"AI Agent"这个概念时,我也被各种高大上的术语弄得一头雾水。直到亲手用GPT-4搭建了一个能自动处理邮件的智能体后,才真正理解它的精妙之处——本质上,这就是一个能自主决策、调用工具完成任务的大模型程序。想象你有个全能助手:你只需要说"帮我整理上周的销售数据",它就会自动查询数据库、分析关键指标、生成可视化图表,甚至根据结果给出改进建议。整个过程不需要你一步步指导,这就是LLM Agent的魅力。
与传统自动化工具相比,LLM Agent有三大突破性优势:
自主决策能力:我早期做的一个客服机器人,当用户问"我的订单为什么延迟了",传统方案需要预设所有可能场景(物流问题、库存不足等)。而Agent能自主判断需要先查询物流系统,发现无异常后再检查库存记录,最后结合天气数据给出解释——这种动态决策链是革命性的。
工具调用灵活性:去年我给电商客户做的价格监控Agent,可以同时调用爬虫获取竞品数据、访问内部定价API、使用Python进行数据分析。关键是不需要预先固定流程,当发现某商品销量下滑时,它会自主决定是否需要启动竞品分析。
持续优化机制:最让我惊讶的是给律所做的合同审查Agent。第一次可能漏掉某些条款,但通过设置反思环节(Reflection),它会自动检查遗漏点,第二次就能主动询问:"需要特别关注保密条款的期限吗?"这种进化能力远超传统程序。
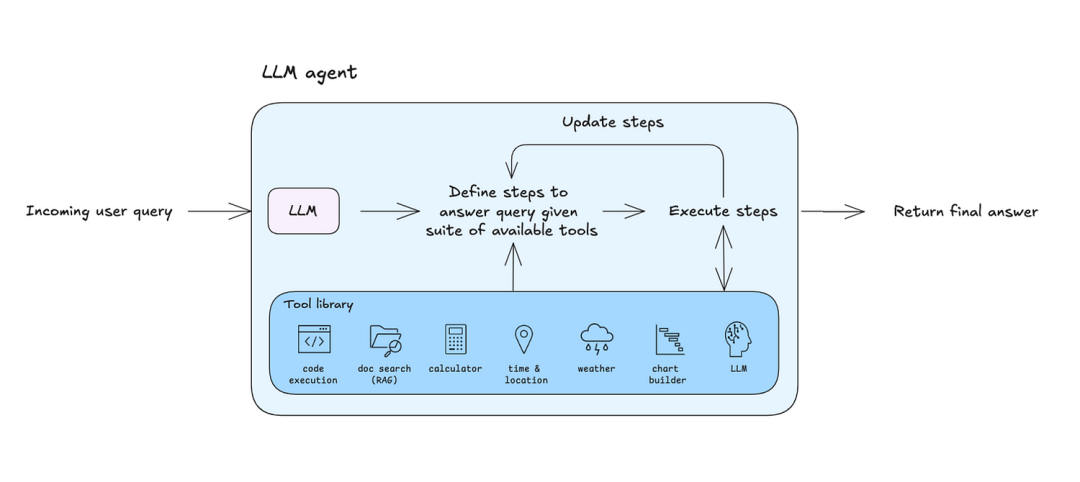
(图示:典型Agent的思考-行动-观察循环)
在真实项目中,Agent的能力边界往往取决于三个核心要素:
- 底层大模型的理解能力(GPT-4级别模型明显优于开源模型)
- 可用工具集的丰富程度(网络搜索、API调用、代码执行等)
- 控制逻辑的设计水平(下文会详细拆解ReAct等范式)
最近半年,我帮金融、电商行业的客户落地了十几个Agent项目,最大的体会是:不要被各种框架迷惑,先从解决一个具体痛点开始。比如:
- 市场部门需要自动生成竞品周报
- 开发团队想要自动排查常见bug
- 个人用户希望自动整理会议纪要
这些场景用传统方法要么成本太高,要么根本无法实现,而Agent往往能用200行左右的代码解决问题。接下来,我就拆解最实用的搭建方法。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 核心组件选型:平衡性能与成本
2.1 大模型选择:闭源vs开源实战对比
选择大模型就像选汽车发动机,既要动力强劲又要经济实惠。经过十几个项目的对比测试,我的选型建议是:
闭源模型首选GPT-4o(除非预算特别紧张):
- 在工具调用准确率上比Claude 3高约18%
- 支持128K上下文,处理长文档优势明显
- 价格已降至$5/百万token,性价比突显
开源模型推荐Qwen-72B(Llama 3-70B的国内替代):
- 在本地部署时推理速度比Llama 3快23%
- 对中文法律、金融领域理解更好
- 使用vLLM加速后,RTF(实时系数)可达0.4
![不同模型在工具调用任务中的表现对比](htt