
 神奇激光世界
1. PaddleOCR-VL-1.5:突破性文档解析技术解析
在文档智能处理领域,百度PaddlePaddle团队最新发布的PaddleOCR-VL-1.5模型引起了广泛关注。这个仅0.9B参数的紧凑型视觉语言模型(VLM),在OmniDocBench v1.5基准测试中创造了94.5%的最新准确率记录。更令人印象深刻的是,它在处理真实场景中的各种物理畸变时展现出的强大鲁棒性——这是当前大多数文档解析系统面临的共同挑战。
1.1 为什么文档解析如此重要?
文档作为人类知识的主要载体,其数量和复杂度正呈指数级增长。从学术论文到财务报表,从合同文书到历史档案,高效准确的文档解析技术已成为数字化转型的关键基础设施。传统OCR技术仅能实现文字识别,而现代文档解析系统需要实现:
- 深层结构重建(识别文本块、表格、公式等元素)
- 语义版面理解(推断逻辑阅读顺序)
- 多模态内容解析(文字、图表、印章等)
这些能力为下游的检索增强生成(RAG)系统和大型语言模型(LLM)提供了高质量的数据基础,直接影响着知识管理、智能问答等应用的可靠性。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 核心技术突破
2.1 革命性的PP-DocLayoutV3版面分析引擎
PaddleOCR-VL-1.5的核心创新之一是其升级的PP-DocLayoutV3版面分析引擎。与主流方案相比,它有三大突破:
2.1.1 多点边界框预测
传统方法使用两点坐标的轴对齐矩形框,在处理倾斜或弯曲页面时效果受限。PP-DocLayoutV3采用四边形/多边形表示,通过预测多个边界点(如图1所示),可以精确捕捉非平面文档中的版面元素。
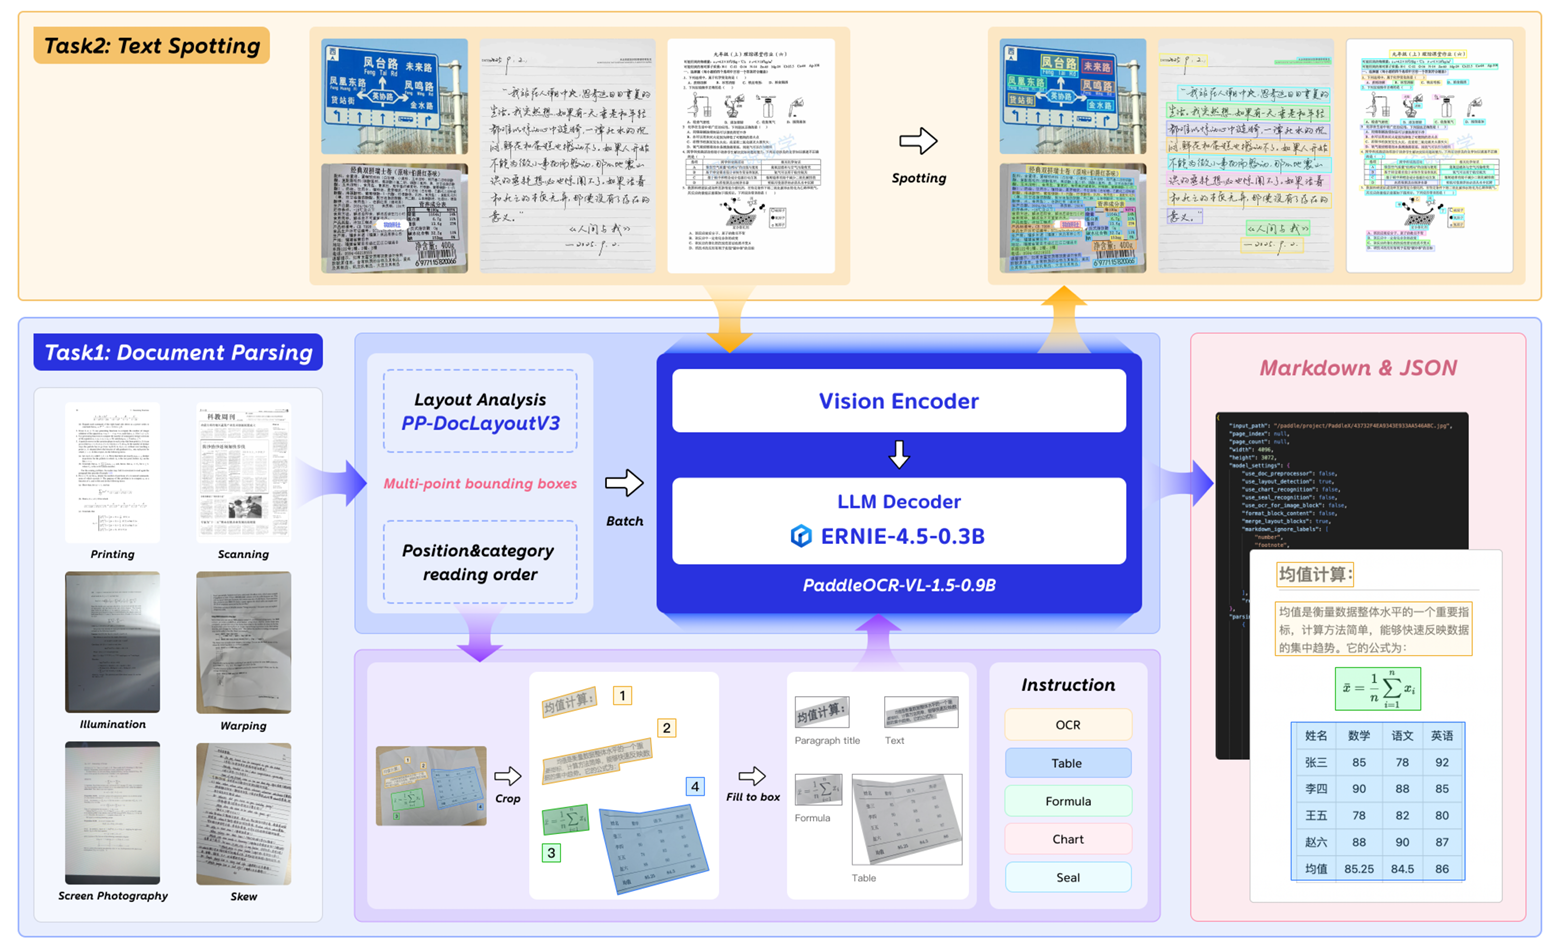
图1:PP-DocLayoutV3的多点边界框预测示意图
2.1.2 端到端的阅读顺序预测
通过将阅读顺序预测直接集成到Transformer解码器层,模型可以同时优化几何定位和逻辑排序。具体实现采用全局指针机制:
python复制# 关系得分计算示例
S_ij = (W_q·q_i)^T(W_k·q_j)/√d_h - (W_q·q_j)^T(W_k·