
 赛雷观影
1. 2025年大语言模型发展全景回顾
2025年对于大语言模型(LLM)领域而言无疑是具有里程碑意义的一年。作为一名长期跟踪AI技术发展的从业者,我亲眼见证了这一年中LLM在推理能力、训练方法和架构创新等方面取得的突破性进展。与往年相比,2025年的技术进步呈现出三个显著特征:模型推理能力质的飞跃、训练成本的大幅降低,以及开源生态的蓬勃发展。
这一年最引人注目的当属DeepSeek团队在1月份发布的R1模型。这个开源模型不仅性能媲美当时的顶尖商业模型(如ChatGPT和Gemini),更重要的是它引入了一种革命性的训练方法——基于可验证奖励的强化学习(RLVR)。这种方法通过在数学和代码等可验证结果的领域应用确定性奖励信号,使模型能够自主发展出类似人类推理的思维链条。
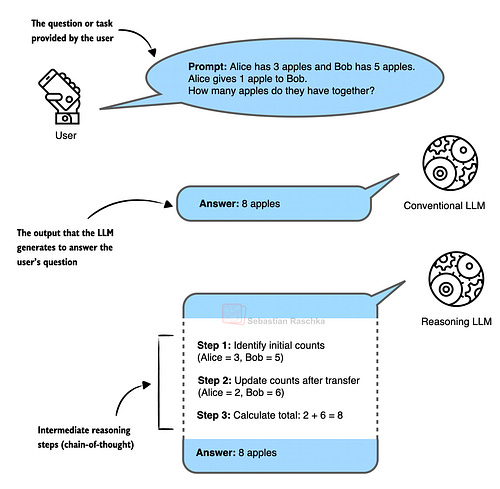
技术细节提示:RLVR的核心创新在于它绕过了传统RLHF需要人工标注偏好的瓶颈,转而利用数学问题答案可验证的特性自动生成奖励信号。这种方法在代码生成等领域同样有效,因为代码的正确性可以通过测试用例自动验证。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 关键技术突破:RLVR与GRPO算法
2.1 训练成本革命
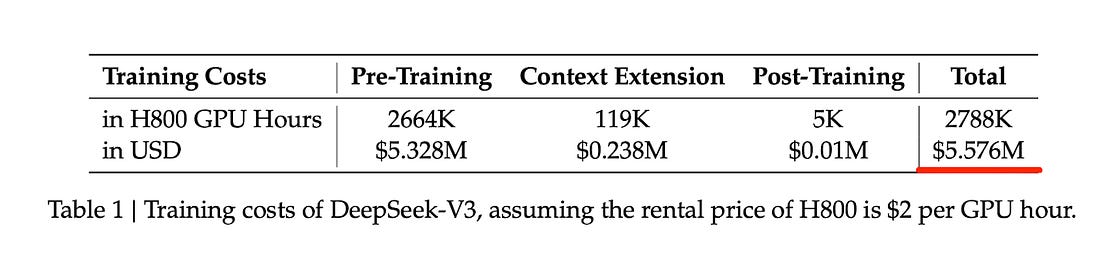
DeepSeek R1带来的第一个冲击是对LLM训练成本的重新评估。根据其补充材料披露,在已有V3模型基础上训练R1仅花费了29.4万美元,这比行业普遍预期的500-5000万美元低了1-2个数量级。这种成本下降主要来自三个方面的优化:
- 计算效率提升:采用混合专家(MoE)架构,仅激活部分参数
- 数据利用优化:通过课程学习策略提高高质量数据的使用效率
- 算法改进:GRPO算法相比传统PPO有更高的样本效率
2.2 GRPO算法详解
GRPO(Generalized Reinforcement Policy Optimi