
 北知春
1. Transformer架构核心解析
在自然语言处理领域,Transformer架构已经成为现代深度学习模型的基石。这种基于自注意力机制的架构彻底改变了序列建模的方式,相比传统的RNN和LSTM具有显著的并行计算优势。让我们从一个标准的Encoder Only结构开始拆解。
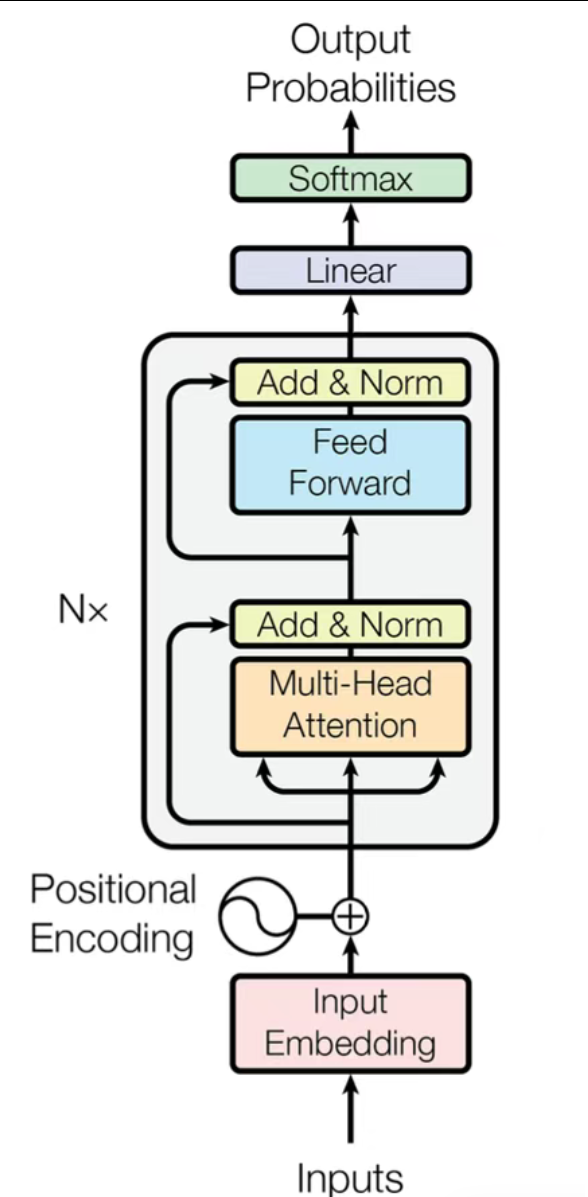
这个架构图展示了典型Transformer Encoder的核心组件。与原始论文中的Encoder-Decoder结构不同,纯Encoder架构常用于BERT等预训练模型。其核心工作流程可以概括为:
- 输入嵌入层将token转换为向量表示
- 位置编码注入序列顺序信息
- 多层自注意力机制进行上下文建模
- 前馈神经网络进行特征变换
- 残差连接和层归一化稳定训练过程
实际工程实现时需要注意:各层的维度必须保持一致,否则残差连接无法直接相加。常见的隐藏层维度为768(base模型)或1024(large模型)。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 自注意力机制深度剖析
2.1 QKV矩阵的本质
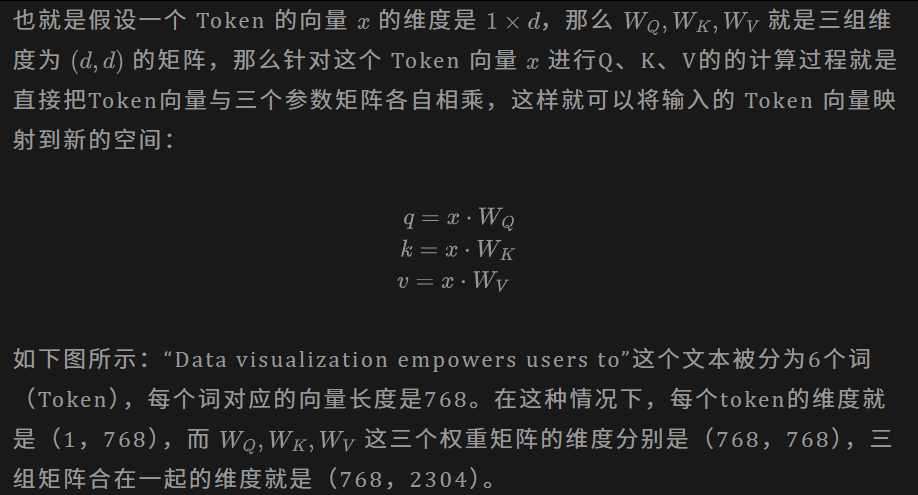
自注意力机制的核心在于Query-Key-Value三元组的计算。这三个矩阵并非凭空产生,而是通过同一输入向量与不同权重矩阵相乘得到的:
- Query(查询):表示当前token想要获取的信息
- Key(键):表示其他token可供匹配的特征
- Value(值):实际要传递的特征信息
数学表达式为:
code复制Q = X * W_Q
K = X * W_K
V = X * W_V
其中W_Q, W_K, W_V是可训练的参数矩阵。
经验分享:初始化这些矩阵时,建议使用Xavier初始化并设置较小的标准差(如0.02),避免训练初期注意力分数差异过大。
2.2 注意力分数计算
![注意力计算过程](https://i-blog.csdnimg.cn/direct/24e6944