
 幸运小姐
1. 茶叶病害智能识别系统概述
在农业生产中,茶叶病害的早期识别对保障茶叶品质和产量至关重要。传统的人工识别方法依赖农技人员的经验判断,不仅效率低下,而且容易因主观因素导致误判。本项目基于PyTorch框架开发了一套完整的茶叶病害智能识别系统,能够自动识别7种常见茶叶病害和健康茶叶状态,为茶叶种植提供了高效的技术支持。
系统核心由三部分组成:数据处理模块、深度学习模型训练模块和图形化应用模块。数据处理模块负责原始图像的标准化处理和训练集/测试集划分;模型训练模块实现了端到端的深度学习流程;图形化应用模块则提供了友好的用户交互界面。整套系统采用模块化设计,各功能组件相互独立又紧密配合,便于后续功能扩展和维护升级。
提示:本项目所有代码文件均采用Python 3.8+编写,主要依赖PyTorch 1.13.1及以上版本。建议使用NVIDIA GPU加速训练过程,但CPU环境也可正常运行(训练速度会显著降低)。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 数据集构建与预处理
2.1 茶叶病害数据集详解
本系统采用的茶叶病害数据集包含8个类别,覆盖7种典型病害和1类健康茶叶样本。具体病害类型包括:
- 红叶斑(Red leaf spot)
- 藻类叶斑(Algal leaf spot)
- 鸟眼斑(Bird eye spot)
- 灰枯病(Gray blight)
- 白点(White spot)
- 炭疽病(Anthracnose)
- 褐枯病(Brown blight)
- 健康茶叶(Healthy)
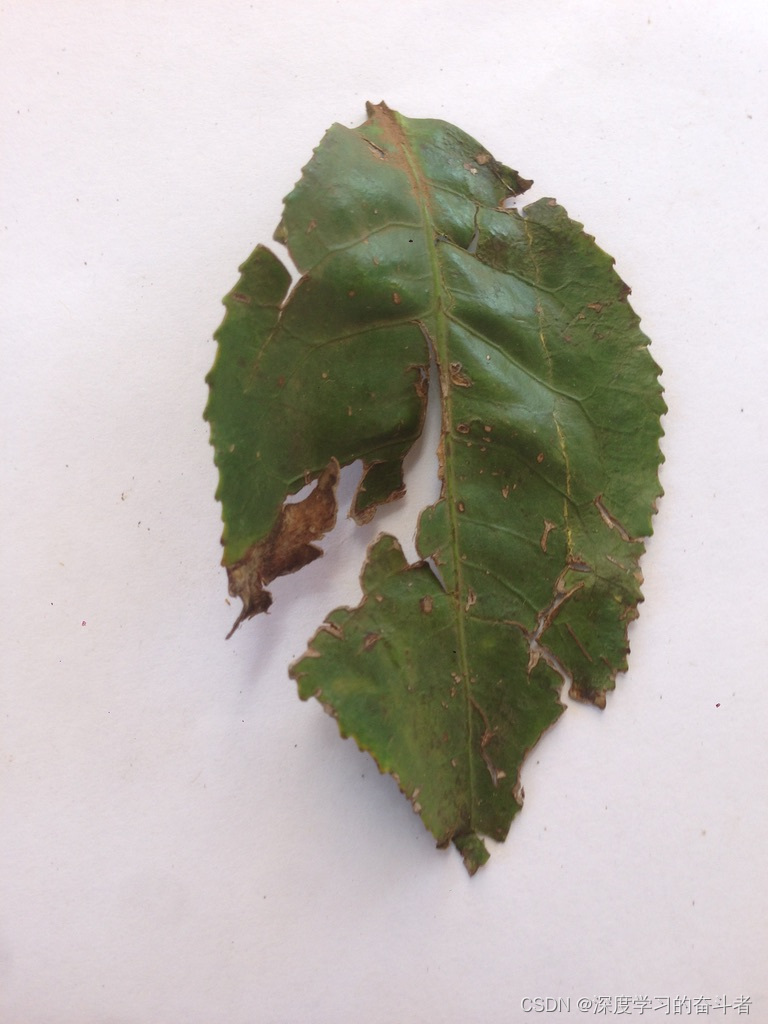
每个类别包含100余张高分辨率彩色图像,总计800余张原始样本。图像采集自不同光照条件、不同生长阶段的茶叶,确保了数据集的多样性和代表性。下图展示了各类病害的典型样本:
2.2 数据预处理流程
原始数据存储在data文件夹中,通过hf.py脚本进行自动化预处理,主要步骤包括:
- 图像标准化:统一调整为256×256像素分辨率,保持长宽比的同时进行智能裁剪
- 数据增强:随机应用旋转(±30°)、水平翻转、亮度调整(±20%)等变换