
 CarrieYung
1. 深度解析:OpenClaw与AI编程助手的真实架构
作为一名长期从事AI基础设施开发的工程师,我经常被问到:"为什么这些AI编程助手不能在本地运行大模型?"今天,我将从架构设计的角度,详细解析OpenClaw这类AI编程助手的内部工作原理。
1.1 核心架构图解:云端大脑与本地执行器
OpenClaw的架构设计遵循了一个基本原则:将计算密集型任务与IO密集型任务分离。这种设计源于现代AI模型的特性——它们需要巨大的计算资源,但对实时IO的要求相对较低。
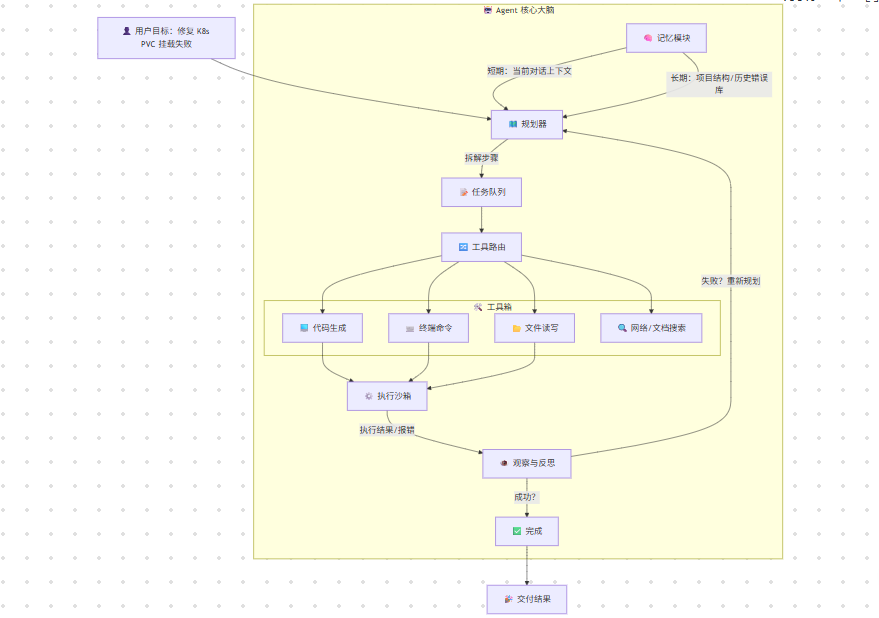
在这个架构中,本地组件主要负责:
- 上下文收集(代码文件、终端输出等)
- 命令执行(运行生成的代码或命令)
- 文件操作(读写项目文件)
云端组件则承担:
- 代码理解与分析
- 解决方案生成
- 任务规划与拆解
这种分工带来的最大优势是:用户可以在普通的开发机上获得接近顶级AI模型的编程辅助能力,而不需要配备昂贵的GPU硬件。
1.2 为什么本地算力不够?显存与计算需求分析
让我们用具体数字来说明这个问题。以目前主流的代码生成模型为例:
| 模型类型 | 参数量 | 最低显存需求(FP16) | 典型硬件配置 | 普通开发机支持度 |
|---|---|---|---|---|
| GPT-4级别模型 | ~1T | 无法本地部署 | 数千张H100集群 | 完全不可能 |
| Llama3-70B | 70B | 140GB | 2×A100 80G | 绝大多数不支持 |
| CodeLlama-34B | 34B | 68GB | 1×A100 80G | 需要专业工作站 |
| DeepSeek-Coder-7B | 7B | 14GB | RT |