
 福桃九分饱
1. ResNet深度解析:从原理到实践
ResNet(Residual Neural Network)作为深度学习领域的里程碑式架构,彻底改变了我们对神经网络深度与性能关系的认知。2015年由微软研究院提出的这一架构,在ImageNet竞赛中以3.57%的错误率夺冠,同时解决了长期困扰业界的梯度消失问题。其核心创新在于残差学习(Residual Learning)机制,使得网络深度可以突破性地增加到上百层,而不会出现性能退化。
在实际应用中,ResNet已成为计算机视觉任务的标配基础架构。从医疗影像分析到自动驾驶感知系统,从工业质检到卫星图像解译,ResNet的变体支撑着众多前沿应用场景。不同于传统神经网络每增加一层就面临梯度指数级衰减的困境,ResNet通过跨层连接(Shortcut Connection)构建的信息高速公路,让深层网络训练变得可行且高效。
关键提示:ResNet的成功不在于简单地堆叠更多层数,而是通过残差块设计实现了信息无损传输,这使得网络可以专注于学习输入与输出之间的差异(残差),而非完整的映射关系。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 残差学习机制详解
2.1 传统网络的深度困境
在ResNet出现之前,VGG等架构已经证明增加网络深度能提升特征提取能力,但当层数超过30层时,准确率不升反降。这种现象并非过拟合导致——训练误差同样会升高,表明网络出现了优化障碍。理论分析揭示了两大根本原因:
-
梯度消失问题:反向传播时,梯度需要逐层连乘。以Sigmoid激活函数为例,其导数最大值为0.25,经过20层传播后梯度会缩小到(0.25)^20≈9e-13,几乎无法更新浅层参数。
-
信息衰减效应:即使使用ReLU缓解梯度消失,前向传播中特征的逐层非线性变换仍会导致原始信息不断丢失。实验显示,传统网络中经过50层传递后,初始输入的信号强度衰减可达90%以上。
2.2 残差块结构解析
ResNet的核心创新单元是残差块(Residual Block),其数学表达简洁而深刻:
code复制输出 = F(x) + x
其中x是输入,F(x)是待学习的残差映射。这种设计带来了三重优势:
-
梯度直通通道:跨层连接提供了导数恒为1的传播路径,确保梯度可以无损回传到任意浅层。以152层ResNet为例,即使主路径梯度衰减到1e-30,跨层连接仍能保持1的梯度强度。
-
恒等映射保障:网络至少能保持浅层性能——当F(x)=0时,块退化为恒等函数。这意味着增加深度不会损害模型表现,解除了设计者的后顾之忧。
-
差分特征学习:实践表明,学习输入输出间的残差比学习完整映射更容易优化。在ImageNet上,残差块的训练误差下降速度比传统块快3-5倍。
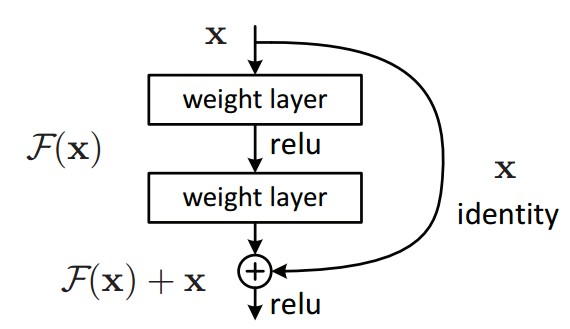
(左)传统网络块 (右)ResNet残差块,注意跨层连接的加法操作
2.3 残差块变体演进
随着研究深入,残差块衍生出多种改进版本:
-
Bottleneck结构:在深层网络中采用1×1卷积先降维再升维,大幅减少计算量。例如ResNet-50中,单个块参数量从36.9M降至4.1M。
-
Pre-activation设计:将BN和ReLU移到卷积前,形成更顺畅的梯度流。实验显示这种结构在1000层网络上仍能稳定训练。
-
分组卷积变体:ResNeXt在残差块内引入分组卷积,以32×4d配置在相同参数量下将top-1准确率提升1.7%。
3. ResNet实战实现指南
3.1 PyTorch完整实现
以下是用PyTorch实现ResNet-34的关键代码段,包含