
 Marco Liu
1. Transformer架构深度解析:从理论到实践
作为一名长期从事NLP领域开发的工程师,我见过太多对Transformer架构的误解和过度解读。今天我想用最直白的方式,带大家真正理解这个革命性架构的本质。不同于学术论文的抽象描述,我会结合自己在中英翻译模型开发中的实战经验,剖析Transformer的每个核心组件。
重要提示:理解Transformer的关键在于把握"它只是一个拟合工具"这一本质。模型本身并不具备智能,真正驱动学习的是损失函数。
1.1 模型整体架构设计
原始Transformer采用经典的Encoder-Decoder结构,这种设计在机器翻译任务中表现出色。但实际应用中我们发现:
- 编码器 负责提取源语言(如中文)的语义特征
- 解码器 逐步生成目标语言(如英文)的词汇序列
- 参数效率 是最大痛点,这也是后来BERT(纯Encoder)和GPT(纯Decoder)兴起的原因
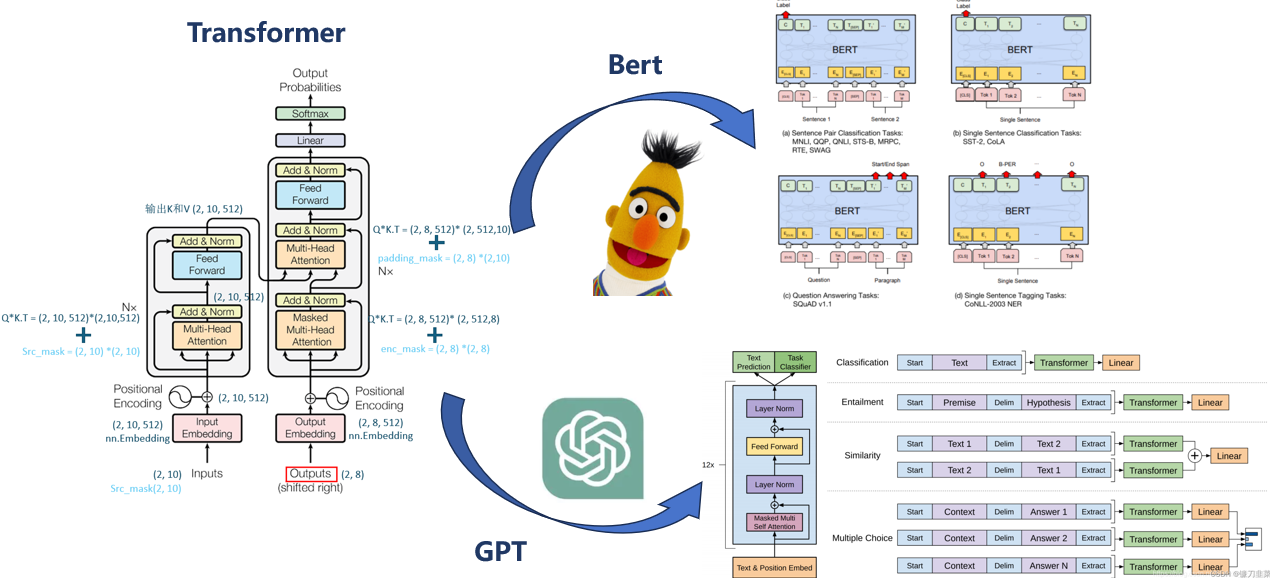
在开发中英翻译模型时,我建议初学者先从完整架构入手。等掌握基本原理后,可以尝试:
- 仅使用Encoder部分做文本分类
- 仅用Decoder部分做文本生成
- 对比不同架构的效果差异
1.2 词嵌入层:从离散符号到连续空间
词嵌入是NLP模型的第一道门槛。很多教程把这个概念神秘化了,其实本质就是:
python复制# PyTorch中的典型实现
self.embedding = nn.Embedding(vocab_size, embedding_dim)
这个简单的查表操作解决了几个关键问题:
- 维度灾难:one-hot向量的维度等于词表大小,而嵌入维度通常只需512或1024
- 语义关系:通过余弦相似度可以计算词与词之间的关系
- 训练效率:反向传播时只更新实际用到的词向量
我在开发翻译模型时发现:
- 中英文需要分别建立词表
- 共享嵌入矩阵可以节省参数但会降低性能
- 预训练词向量能加速收敛约30%
1.3 位置编码:弥补注意力机制的先天缺陷
Transformer最反直觉的设计就是位置编码。为什么需要它?因为自注意力机制本质上是排列不变的(permutation invariant)。举个例子:
"我爱北京"和"北京爱我"在纯注意力机制下可能得到相似的表示。位置编码通过注入顺序信息解决了这个问题。
正弦位置编码的数学表达式:
$$
PE_{(pos,2i)} = \sin(pos/10000^{2i/d_{model}}) \
PE_{(pos,2i+1)} = \cos(pos/10000^{2i/d_{model}})
$$
这种编码方式的特点是:
- 每个位置有唯一编码
- 相对位置信息可以通过线性变换获取
- 能够处理比训练时更长的序列
实际编码示例:
python复制class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_len=5000):
        super().__init__()
        position = torch.arange(max_len).unsqueeze(1)
        div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
        pe = torch.zeros(max_len, d_model)
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        self.register_buffer('pe', pe)

    def forward(self, x):
        return x + self.pe[:x.size(1)]
1.4 自注意力机制:Transformer的核心引擎
自注意力机制常被过度神话,其实质是三个简单的矩阵乘法:
- 查询(Query):当前词要找什么
- 键(Key):每个词有什么
- 值(Value):每个词实际的信息
计算公式:
$$
Attention(Q,K,V)=softmax(\frac{QK^T}{\sqrt{d_k}})V
$$
在开发翻译模型时,我发现几个关键点:
- 缩放因子$\sqrt{d_k}$对训练稳定性至关重要
- 注意力权重可视化能帮助调试模型
- 计算复杂度随序列长度呈平方增长
1.5 多头注意力:并行捕捉不同关系
多头注意力的本质是将注意力机制并行化:
python复制# 典型的多头注意力实现
class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_o = nn.Linear(d_model, d_model)

    def forward(self, q, k, v