
 王若然
1. 项目概述:车架号检测数据集解析
这个VOC+YOLO格式的车架号检测数据集包含3393张640x640分辨率的图片,专门用于训练车辆VIN码识别模型。作为一名长期从事计算机视觉开发的工程师,我发现这类结构化数据集的实用价值在于其标注一致性——所有图片都经过labelImg工具严格标注,每张图片包含且仅包含一个VIN码标注框。
数据集采用双格式存储是其显著特点:
- VOC格式:包含XML文件,记录物体类别和边界框坐标
- YOLO格式:提供归一化后的txt标注文件
这种设计让开发者可以灵活选择训练框架,无论是基于传统目标检测算法还是最新的YOLO系列模型。
提示:虽然数据集未预划分训练集/验证集,但建议按8:1:1比例拆分,这对于小样本学习尤为重要
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 数据集深度解析与技术实现
2.1 数据标注规范与质量验证
通过分析示例图片可以看到,标注框精准包围了车辆挡风玻璃左下角的VIN码区域(如图1所示)。这种标注方式符合GB/T 21085-2007对VIN码位置的规范要求,确保了数据集的工业实用性。
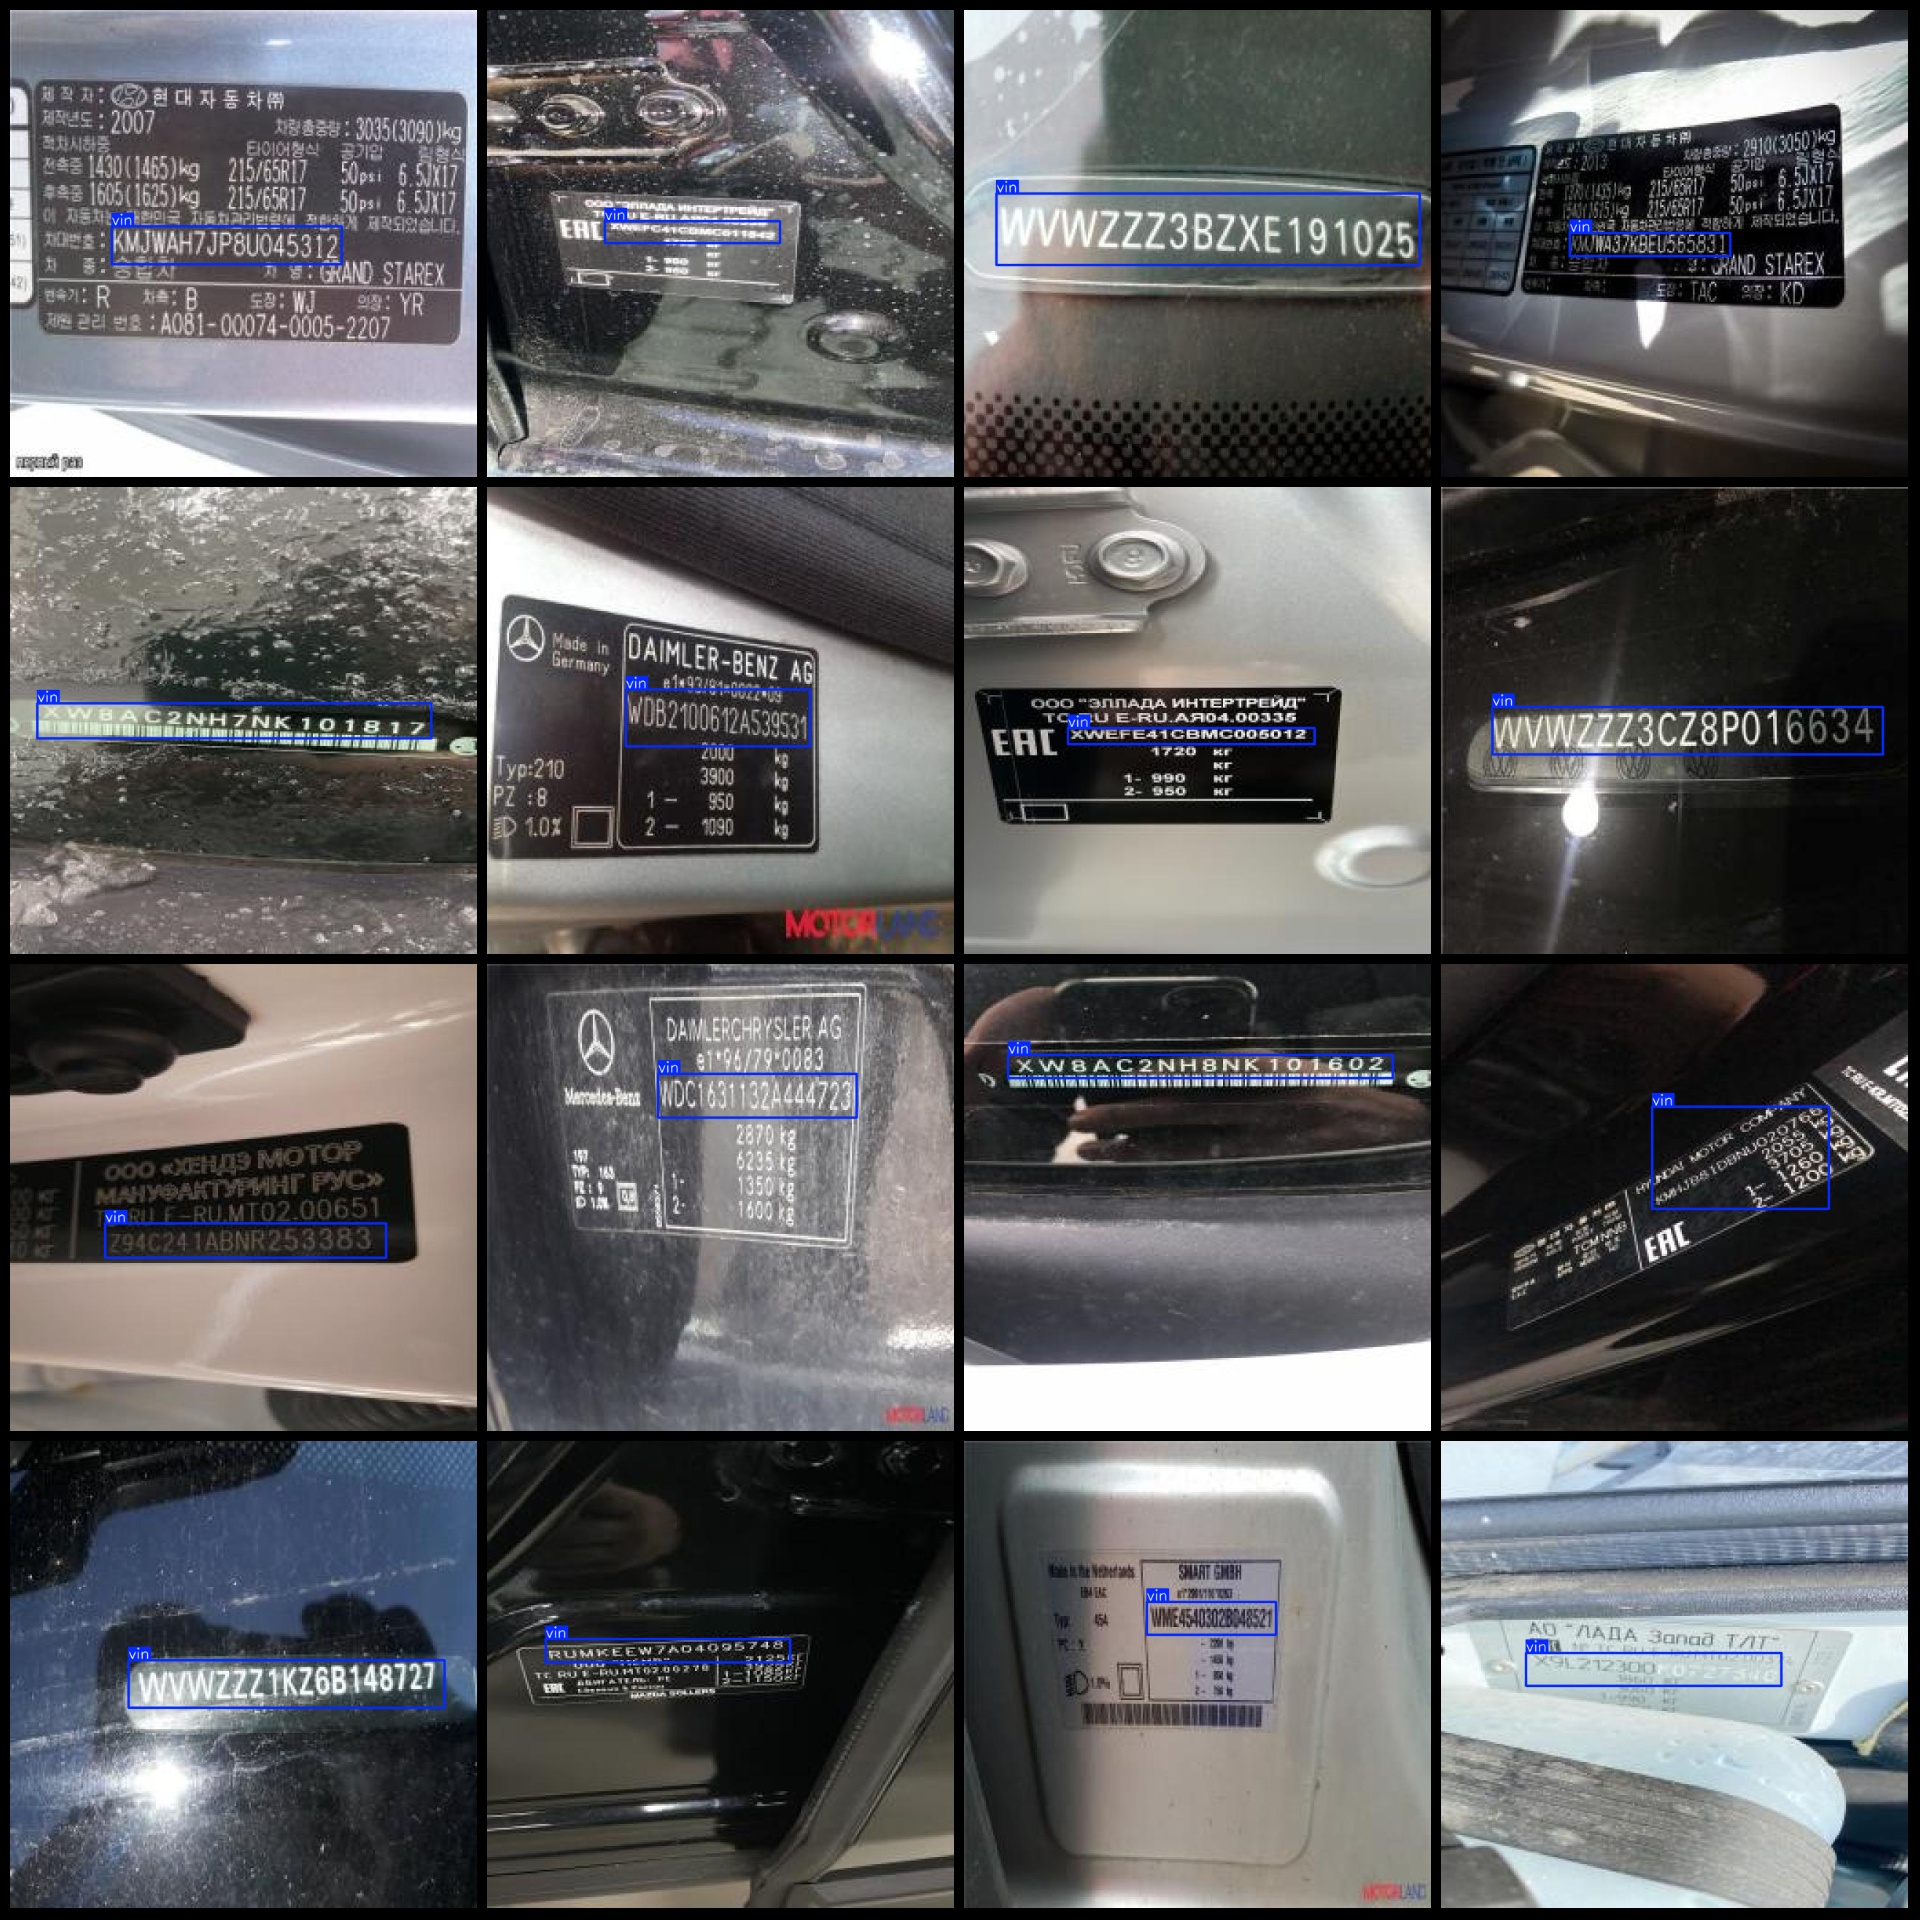
标注质量检查要点:
- 边界框必须完整包含VIN码字符区域
- 保留约10%的周边背景信息
- 避免包含其他干扰文本(如车辆铭牌)
2.2 数据预处理最佳实践
由于所有图片已统一为640x640分辨率,建议采用以下预处理流程:
python复制import cv2
import albumentations as A

transform = A.Compose([
    A.RandomBrightnessContrast(p=0.5),
    A.GaussNoise(var_limit=(10, 50)),
    A.Rotate(limit=5),
    A.Resize(640, 640)
], bbox_params=A.BboxParams(format='yolo'))
关键参数说明:
- 亮度对比度调整:模拟不同光照条件
- 高斯噪声:增强模型抗干扰能力
- 小角度旋转:应对拍摄角度偏差