mzhdsb
1. 从零开始理解Dify平台的核心架构
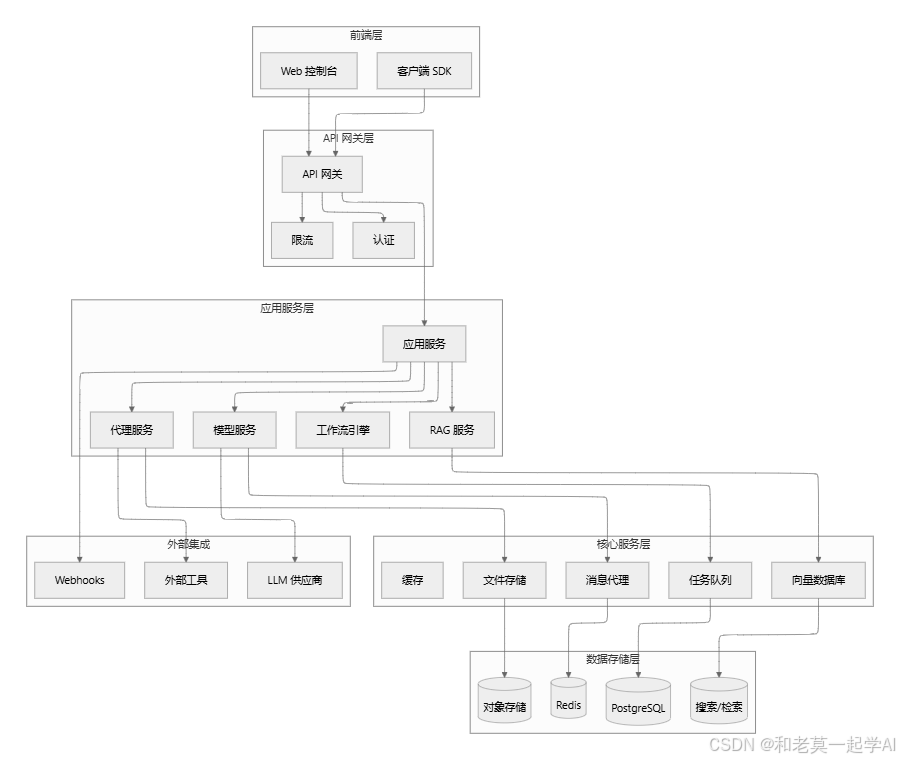
作为一名在大模型领域摸爬滚打多年的技术老兵,我见证了从早期单模型调用到如今复杂AI工作流编排的技术演进。Dify平台的出现,恰好解决了当前AI应用开发中最棘手的工程化问题。不同于简单的模型调用工具,Dify将工作流引擎、RAG管道、智能代理、模型生态和运维观测等核心组件深度融合,形成了一个完整的生产级AI开发平台。
1.1 为什么需要Dify这样的平台?
在传统的大模型应用开发中,开发者往往需要自行搭建以下基础设施:
- 模型调用和路由管理
- 知识库的构建和检索系统
- 复杂任务的工作流编排
- 工具调用和外部系统集成
- 全链路的监控和运维
这种分散的开发模式不仅效率低下,而且难以保证系统的稳定性和可维护性。Dify通过平台化的方式,将这些功能模块标准化、可视化,让开发者可以专注于业务逻辑的实现,而非底层基础设施的搭建。
1.2 Dify平台的核心组件
Dify的架构设计遵循了现代软件工程的微服务理念,将不同功能模块解耦,提高了系统的可扩展性和维护性。主要包含以下核心组件:
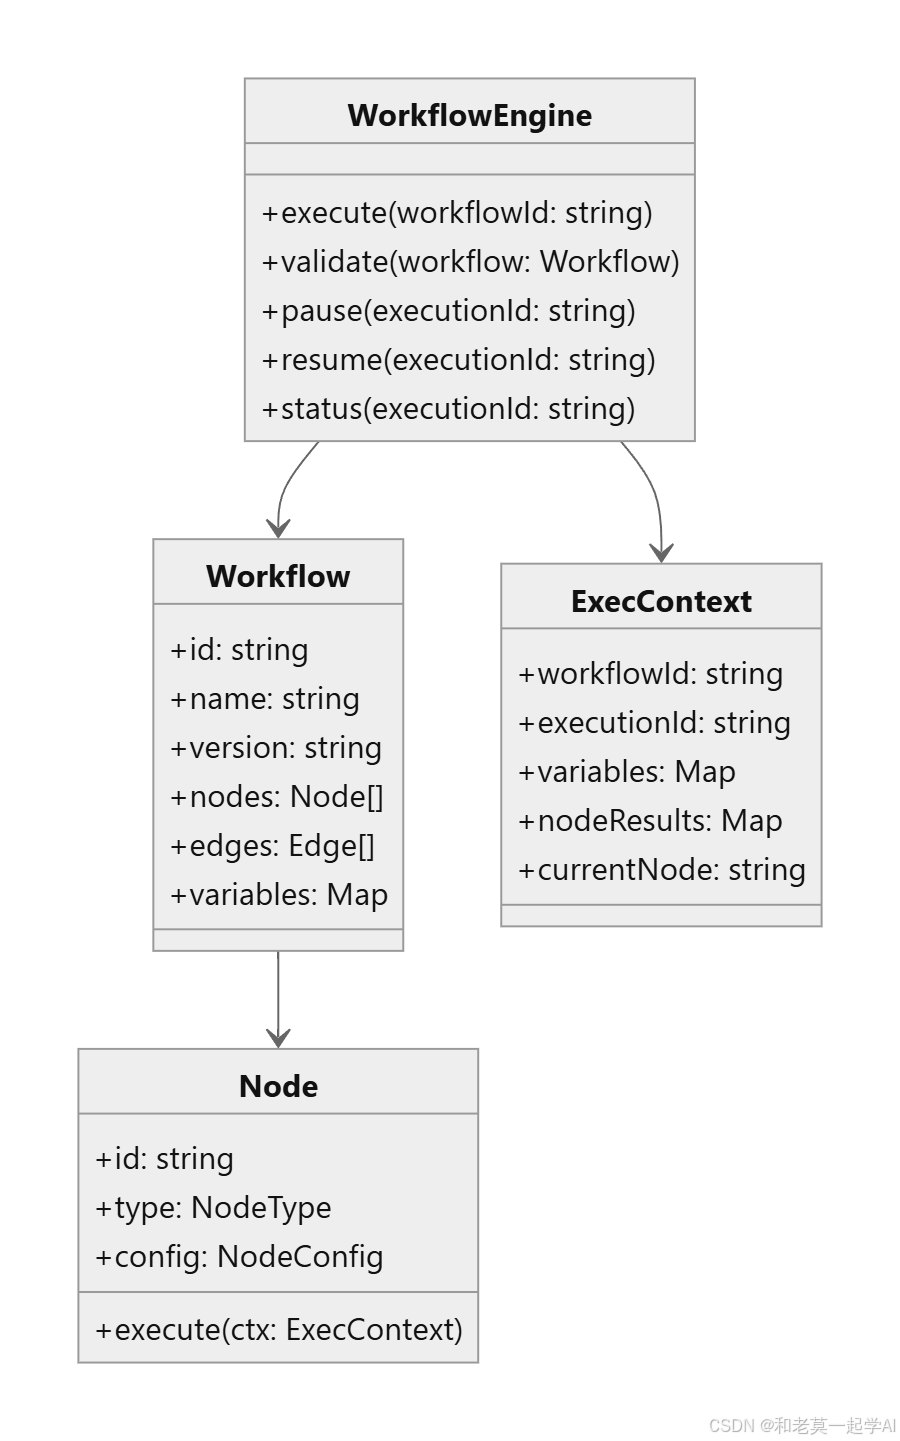
- 工作流引擎:提供画布化的节点编排能力,支持条件分支、循环、上下文变量等高级特性,并内置调试功能
- RAG管道:实现从文档摄取、解析、切分、向量化到检索、重排的端到端知识增强流程
- 代理系统:支持Function Calling和ReAct两种模式,内置50+工具,同时支持自定义工具扩展
- 模型与路由:统一管理多供应商、多模型,提供智能路由和负载调度能力
- 观测与运维:提供日志、指标、用量、错误分析等全面的运维能力,支持持续优化和回放
- BaaS接口:通过REST/SDK方式提供标准化接口,便于与现有业务系统集成
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 深入解析Dify工作流引擎
2.1 工作流引擎的设计哲学
Dify工作流引擎的核心目标是实现"检索→增强→生成→调用工具→条件分支→循环→输出"的完整流程可视化编排。这种设计使得整个AI应用的工作流程变得可观察、可调试、可回放,极大提升了开发效率和系统可靠性。
2.2 节点类型与变量管理
工作流引擎支持多种节点类型,每种类型都有特定的功能和适用场景:
- LLM节点:负责大模型的调用和结果处理
- 条件节点:实现基于条件的流程分支
- 工具节点:执行外部工具或API的调用
- 数据处理节点:进行数据的转换、清洗和增强
- 分支与汇合节点:实现并行处理和结果合并
变量与上下文管理是工作流引擎的另一大特色。上下文变量贯穿整个执行链路,支持节点间的参数传递和结果复用,大大增强了工作流的灵活性和表达能力。
2.3 工作流执行流程详解
工作流引擎的执行流程经过精心设计,确保高效可靠:
- 解析与装配:加载工作流定义,进行拓扑排序和DAG校验(确保无环、入口出口唯一)
- 实例化:创建运行实例,初始化上下文与运行选项(超时、重试、并发度等)
- 触发分发:入口节点就绪后入队,调度器按优先级和并发令牌派发到执行器
- 节点执行:执行器拉取节点,获取上下文,调用对应Operator/Connector,产生输出和事件
- 状态持久化:节点结果持久化(成功/失败/中断),更新就绪队列(满足入度的下游节点入队)
- 并行与汇聚:分支节点并行派发;Join/Barrier等待全部分支完成或按策略早停
- 错误处理:节点失败触发重试(采用指数退避+抖动策略),失败后进入补偿/回滚或错误分支
- 完成归档:出口节点完成后,聚合指标与日志,生成可追溯的执行报告