
 weixin_29197699
1. Vespa:AI时代的检索与排序引擎解析
在信息爆炸的AI时代,如何从海量数据中快速准确地找到最相关的结果,已经成为各类应用的核心挑战。无论是电商平台的商品推荐、内容平台的个性化feed,还是企业内部的文档检索系统,都需要处理复杂的多模态查询需求。传统的关键词检索(如Elasticsearch)或新兴的向量数据库(如Milvus)往往只能解决单一场景的问题,而Vespa作为一款开源的检索与排序服务平台,通过创新的混合检索架构,正在重新定义AI时代的搜索体验。
Vespa的核心价值在于它打破了传统检索系统的边界,将关键词匹配、向量搜索、结构化过滤和多阶段排序等能力深度融合。这种设计使得开发者可以用统一的查询语法,同时处理"距离五百米以内的川菜馆"(空间查询)、"评分4.5以上的餐厅"(结构化过滤)和"环境安静适合聊天"(语义搜索)这类复合需求。更重要的是,Vespa原生支持实时更新和在线推理,使得AI模型可以直接参与检索过程的决策,为RAG(检索增强生成)、推荐系统等场景提供了开箱即用的解决方案。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 混合检索:Vespa的核心创新
2.1 混合检索的技术本质
混合检索(Hybrid Retrieval)不是简单地将多种检索方式拼凑在一起,而是通过统一的执行框架,让不同类型查询条件可以协同工作。以一个典型的餐厅搜索为例:
sql复制"找距离五百米以内,人均消费25元,评价4.5分以上,且不用排队的川菜馆"
这个查询实际上包含了四种不同的检索需求:
- 空间检索:基于GIS的位置过滤(500米内)
- 结构化过滤:数值范围的精确匹配(人均25元,评分4.5+)
- 关键词匹配:品类标签的精确匹配("川菜")
- 语义搜索:用户评价的语义理解("不用排队")
Vespa的创新之处在于,它将这些异构的查询条件编译成统一的执行计划,在索引结构、查询优化和结果合并等层面进行深度整合,而非简单地后处理拼接。
2.2 混合检索的工程实现
在底层实现上,Vespa通过以下技术确保混合检索的高效执行:
索引结构融合:
- 倒排索引:处理关键词匹配(如"川菜")
- B+树索引:处理数值范围查询(如评分>4.5)
- HNSW图:处理向量相似度搜索(如"不用排队"的语义匹配)
- R树:处理空间查询(如500米范围内)
查询执行优化:
python复制# Vespa查询执行流程示例
def execute_query(query):
    # 阶段1:过滤条件快速剪枝
    candidates = apply_geo_filter(query.geo)          # 空间过滤
    candidates = apply_structured_filters(candidates) # 结构化过滤

    # 阶段2:混合召回
    keyword_results = keyword_search(query.text)      # 关键词匹配
    vector_results = vector_search(query.vector)      # 向量搜索
    hybrid_results = merge_results(keyword_results, vector_results)

    # 阶段3:精排
    final_results = rerank(hybrid_results, query)
    return final_results
这种分阶段处理的设计,使得Vespa可以先用低成本操作快速缩小候选集,再对精减后的数据执行计算密集型操作(如向量搜索),从而在保证质量的同时控制延迟。
3. Vespa的架构设计
3.1 整体架构解析
Vespa采用经典的分布式系统设计,主要包含以下组件:
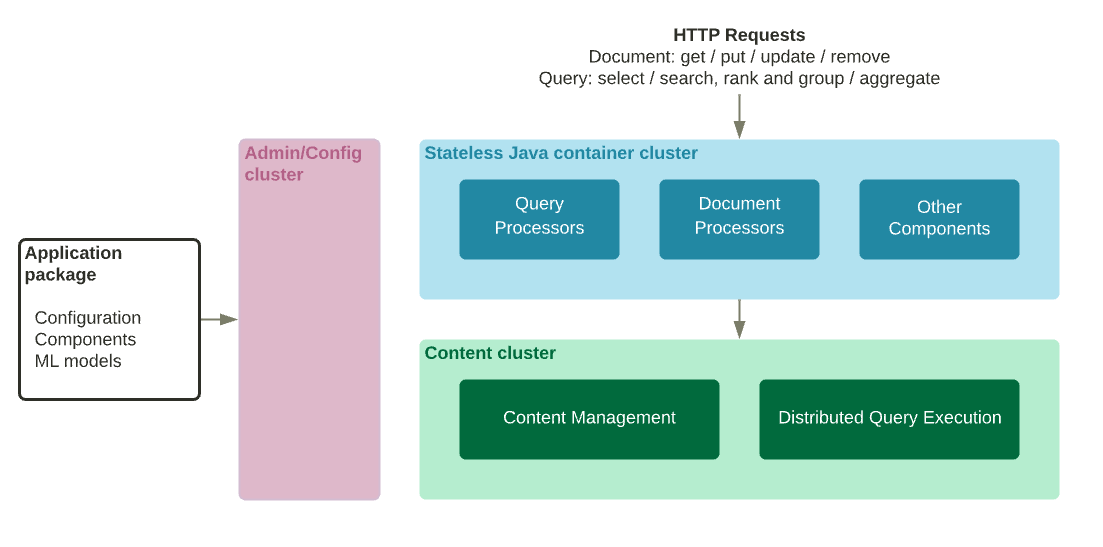
核心组件:
- 容器层(Container):处理查询路