
 慕北颖
1. AI代理的日常化困境:为何强大能力难以落地?
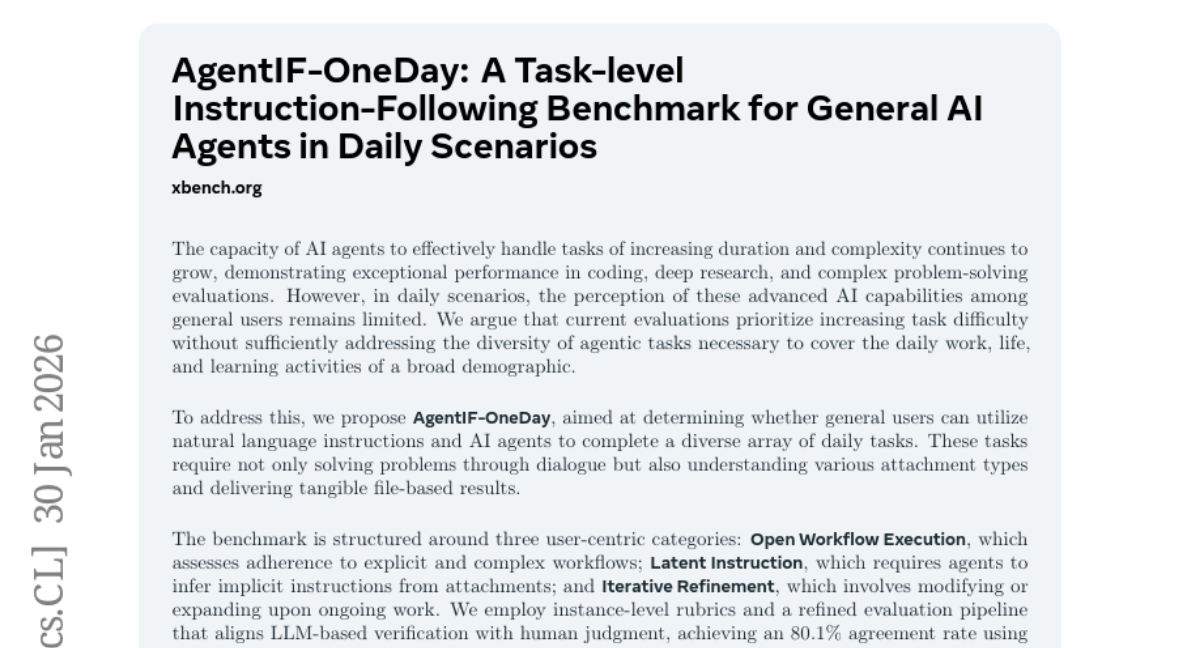
作为一名长期跟踪AI技术发展的从业者,我注意到一个有趣的现象:当前最先进的AI代理(Agent)系统在专业领域展现出惊人的能力——它们可以编写复杂代码、进行深度学术研究、解决专业级难题。但当我向身边非技术背景的朋友推荐这些工具时,得到的反馈往往是"听起来很厉害,但对我没什么用"。这种割裂感促使我深入研究了xbench实验室的最新成果,他们的发现揭示了AI普及化面临的核心挑战。
1.1 能力与需求的错位
当前AI评估体系存在一个根本性问题:过度追求"高难度"而忽视"实用性"。主流基准测试如MMLU、GPQA等都在比拼AI解决复杂学术问题的能力,就像用奥林匹克数学题来评估一个家庭保姆是否称职。这种导向导致AI研发资源集中投入在提升极端场景下的表现,而忽略了日常场景中的用户体验。
我在实际测试中发现,让AI写一首莎士比亚风格的十四行诗比让它规划一周健康食谱更容易获得满意结果。这不是技术能力问题,而是产品设计思路的偏差——我们教会了AI表演杂技,却忘了教它走路。
1.2 日常任务的特殊挑战
日常场景对AI提出了不同于专业领域的独特要求:
- 模糊性需求:用户往往无法精确表达需求,如"帮我找个适合家庭聚餐的餐厅",其中隐含的价格区间、口味偏好、交通便利等条件需要AI主动推断
- 多模态处理:需要同时理解文字、图片、PDF等不同格式的输入,如从混乱的微信聊天记录中提取会议要点
- 状态持续性:任务常跨越多个会话,如旅行规划可能涉及机票预订、酒店选择、行程安排等多个环节的持续优化
这些特点使得传统基于单一指令、明确目标的评估体系难以准确反映AI在日常场景中的真实表现。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. AgentIF-OneDay评估框架解析
xbench实验室提出的AgentIF-OneDay框架从根本上重构了评估逻辑。通过分析其设计,我们可以理解如何构建真正实用的AI系统。
2.1 三维评估体系设计
2.1.1 开放式工作流程执行
这个维度测试AI严格遵循多步骤指令的能力。我设计过一个典型测试