
 賴明宗
1. Transformer自注意力机制的本质与实现原理
1.1 自注意力机制的生物学启示
人类阅读句子"小明把苹果递给了小红,因为她饿了"时,大脑会自然建立"她"与"小红"的关联。这种认知机制正是自注意力(Self-Attention)的灵感来源。在神经网络中,自注意力通过数学建模实现了类似的关联分析能力,其核心在于让序列中的每个元素都能动态关注到其他相关元素。
关键理解:自注意力不是简单的特征提取,而是建立元素间的动态关系图谱
1.2 QKV向量的数学内涵
每个输入token通过三个独立的线性变换生成:
- Query(查询向量):表示当前token想要获取的信息特征
- Key(键向量):表示当前token可提供的特征标识
- Value(值向量):承载token的实际语义内容
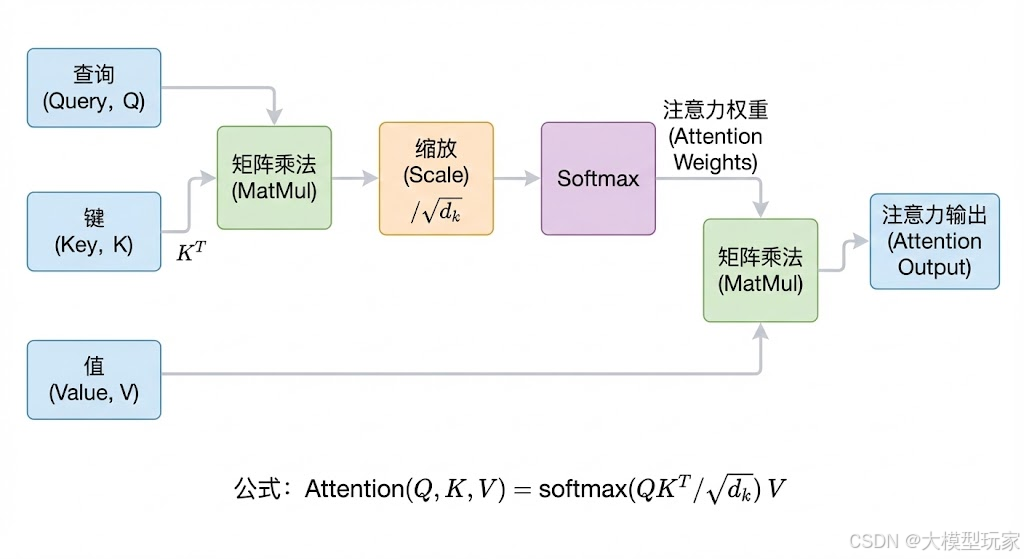
计算过程详解:
- 相似度计算:Query与所有Key的点积运算,本质是计算余弦相似度
- 公式:$score(q_i, k_j) = q_i \cdot k_j^T$
- 缩放处理:除以$\sqrt{d_k}$(Key向量维度)防止梯度消失
- 技术细节:当$d_k$较大时,点积结果方差增大,Softmax会趋向极值
- 权重归一化:Softmax转换为概率分布
- 数学表达:$\alpha_{ij} = \text{softmax}(\frac{QK^T}{\sqrt{d_k}})$
- 上下文聚合:加权求和Value向量
- 最终输出:$Z = \alpha V$
1.3 多头注意力的设计哲学
原始Transformer采用8个注意力头(Attention Head),其技术价值在于:
- 子空间学习:将768维嵌入拆分为8个64维子空间
- 优势:不同头可专注不同特征模式(语法/语义/指代等)
- 并行计算:各头独立计算后拼接结果
- 实现方式:$MultiHead(Q,K,V) = Concat(head_1,...,head_h)W^O$
- 模型容量:增加非线性变换层提升表达能力
![多头注意力结构图](