
 廷哥带你小路超车
1. 为什么选择Ollama在本地部署大模型?
作为一名长期关注AI技术落地的开发者,我一直在寻找能够在个人电脑上高效运行大语言模型的解决方案。Ollama的出现彻底改变了这个局面——它让大模型部署变得像安装普通软件一样简单。相比传统的复杂部署流程,Ollama提供了开箱即用的体验,特别适合想要快速体验大模型能力的开发者和技术爱好者。
Ollama的核心优势在于其轻量化的架构设计。它采用类似Docker的模型管理方式,将模型、运行环境和依赖全部打包成独立的"容器",实现了真正的即装即用。这种设计不仅简化了部署流程,还解决了传统部署中常见的环境冲突问题。在我的实际使用中,从安装到运行第一个模型,整个过程不超过10分钟。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 环境准备与安装指南
2.1 硬件需求评估
在开始安装前,我们需要评估本地硬件是否满足运行大模型的基本要求。虽然Ollama支持多种规模的模型,但不同参数量的模型对硬件的要求差异很大:
- 小型模型(<3B参数):如qwen3.5:0.8b,可在8GB内存的普通笔记本上流畅运行
- 中型模型(7B-13B参数):建议16GB以上内存,最好配备独立显卡
- 大型模型(>13B参数):需要专业级显卡(如RTX 3090及以上)和32GB以上内存
提示:初次尝试建议从小型模型开始,待熟悉操作流程后再尝试更大规模的模型。
2.2 安装步骤详解
- 访问Ollama官网(https://ollama.com/download),下载Windows版本安装包
- 双击运行安装程序,按照向导完成安装(建议保持默认路径)
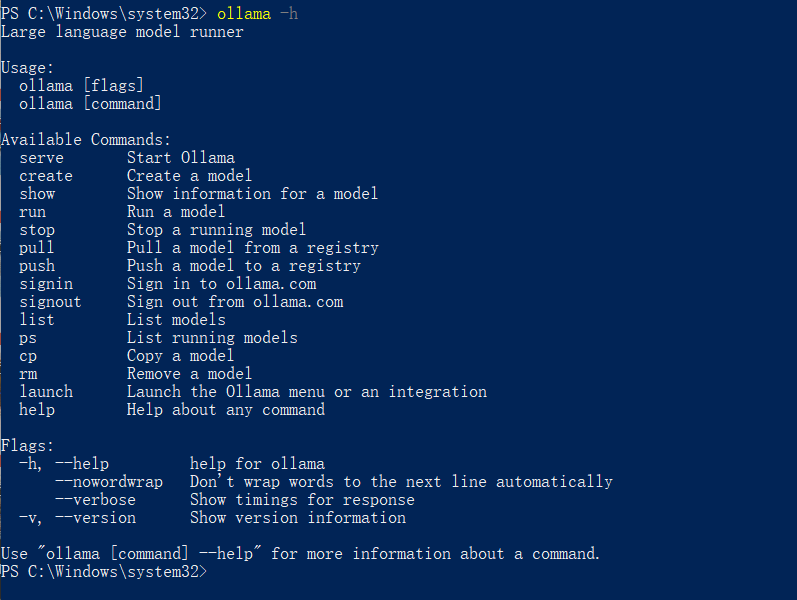
- 安装完成后,打开命令提示符(cmd)或PowerShell,输入以下命令验证安装:
bash复制
ollama -h - 确认看到帮助信息输出,表明安装成功
3. 模型管理与操作全指南
3.1 核心命令解析
Ollama的命令设计借鉴了Docker的简洁风格,主要包含以下核心命令:
| 命令 | 功能说明 | 使用示例 |
|-----