
 锺一勺
1. RAG技术核心问题解析
1.1 大模型的知识固化困境
大型语言模型(LLM)本质上是一个参数化的知识库,其知识获取方式存在根本性限制。在预训练阶段,模型通过海量文本数据学习统计规律,将知识编码到数十亿个参数中。这个过程就像制作一本纸质百科全书——印刷完成后内容就固定了,无法自动更新。
这种架构特性导致三个关键问题:
- 知识时效性:模型训练数据存在明确截止日期。以GPT-4为例,其知识截止于2023年6月,之后发生的所有事件都无法被模型知晓
- 私有知识缺失:企业内部的合同模板、产品手册等专有数据从未进入公开训练集
- 幻觉生成:当模型缺乏相关知识时,会基于语言模式生成看似合理实则错误的答案
关键理解:这三个问题本质是同源的,都源于知识被"冻结"在模型参数中。传统解决方案如全量微调不仅成本高昂(单次训练成本超过千万美元),而且无法实现知识的实时更新。
1.2 RAG的破局思路
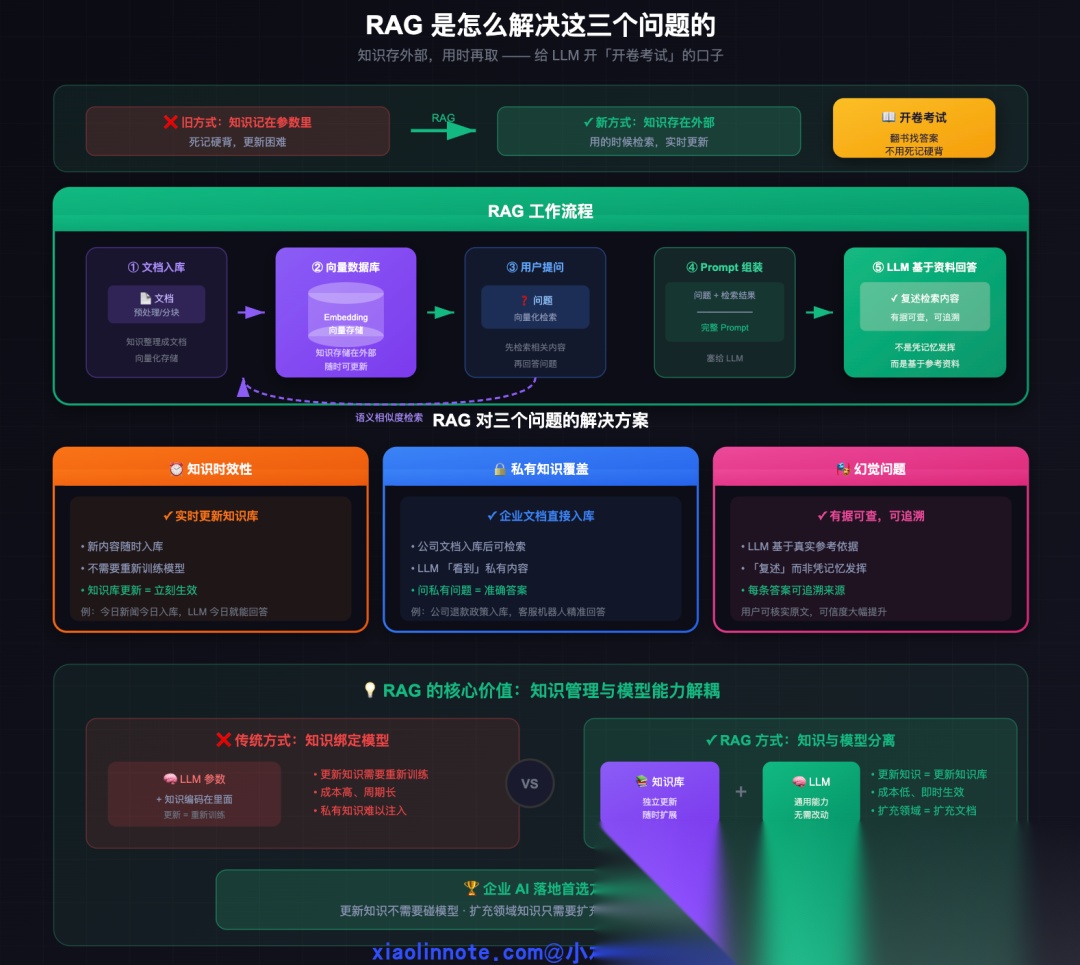
检索增强生成(Retrieval-Augmented Generation)采用了一种革命性的设计范式:
- 知识外置:将动态知识存储在向量数据库等外部系统中
- 实时检索:根据用户查询实时获取最新相关文档
- 上下文注入:将检索结果作为prompt的一部分输入模型
这种架构带来三大优势:
- 知识可更新:修改数据库即可更新模型知识,无需重新训练
- 答案可溯源:每个回答都能追溯到参考文档,提高可信度
- 成本可控:仅需维护检索系统,避免频繁的模型微调
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. RAG技术实现详解
2.1 核心组件与工作流程
一个完整的RAG系统包含以下关键组件:
| 组件 | 功能 | 典型实现 |
|---|---|---|
| 文档处理器 | 文本清洗/分块 | LangChain TextSplitter |
| 嵌入模型 | 文本向量化 | OpenAI text-embedding-ada-002 |
| 向量数据库 | 相似性检索 | Pineco |