
 谢丽鹿
1. 问题现象解析
最近在本地环境调试Ollama时,发现一个挺有意思的现象:明明机器配备了Intel Arc显卡,但运行大语言模型时GPU使用率始终上不去。具体表现为两种典型情况:
第一种情况是启动Ollama时,日志明确显示使用的是CPU算力。这种情况最直观,从日志就能直接判断硬件加速未生效。我截取了终端输出的典型截图(见下图),可以看到计算设备识别为CPU而非GPU。
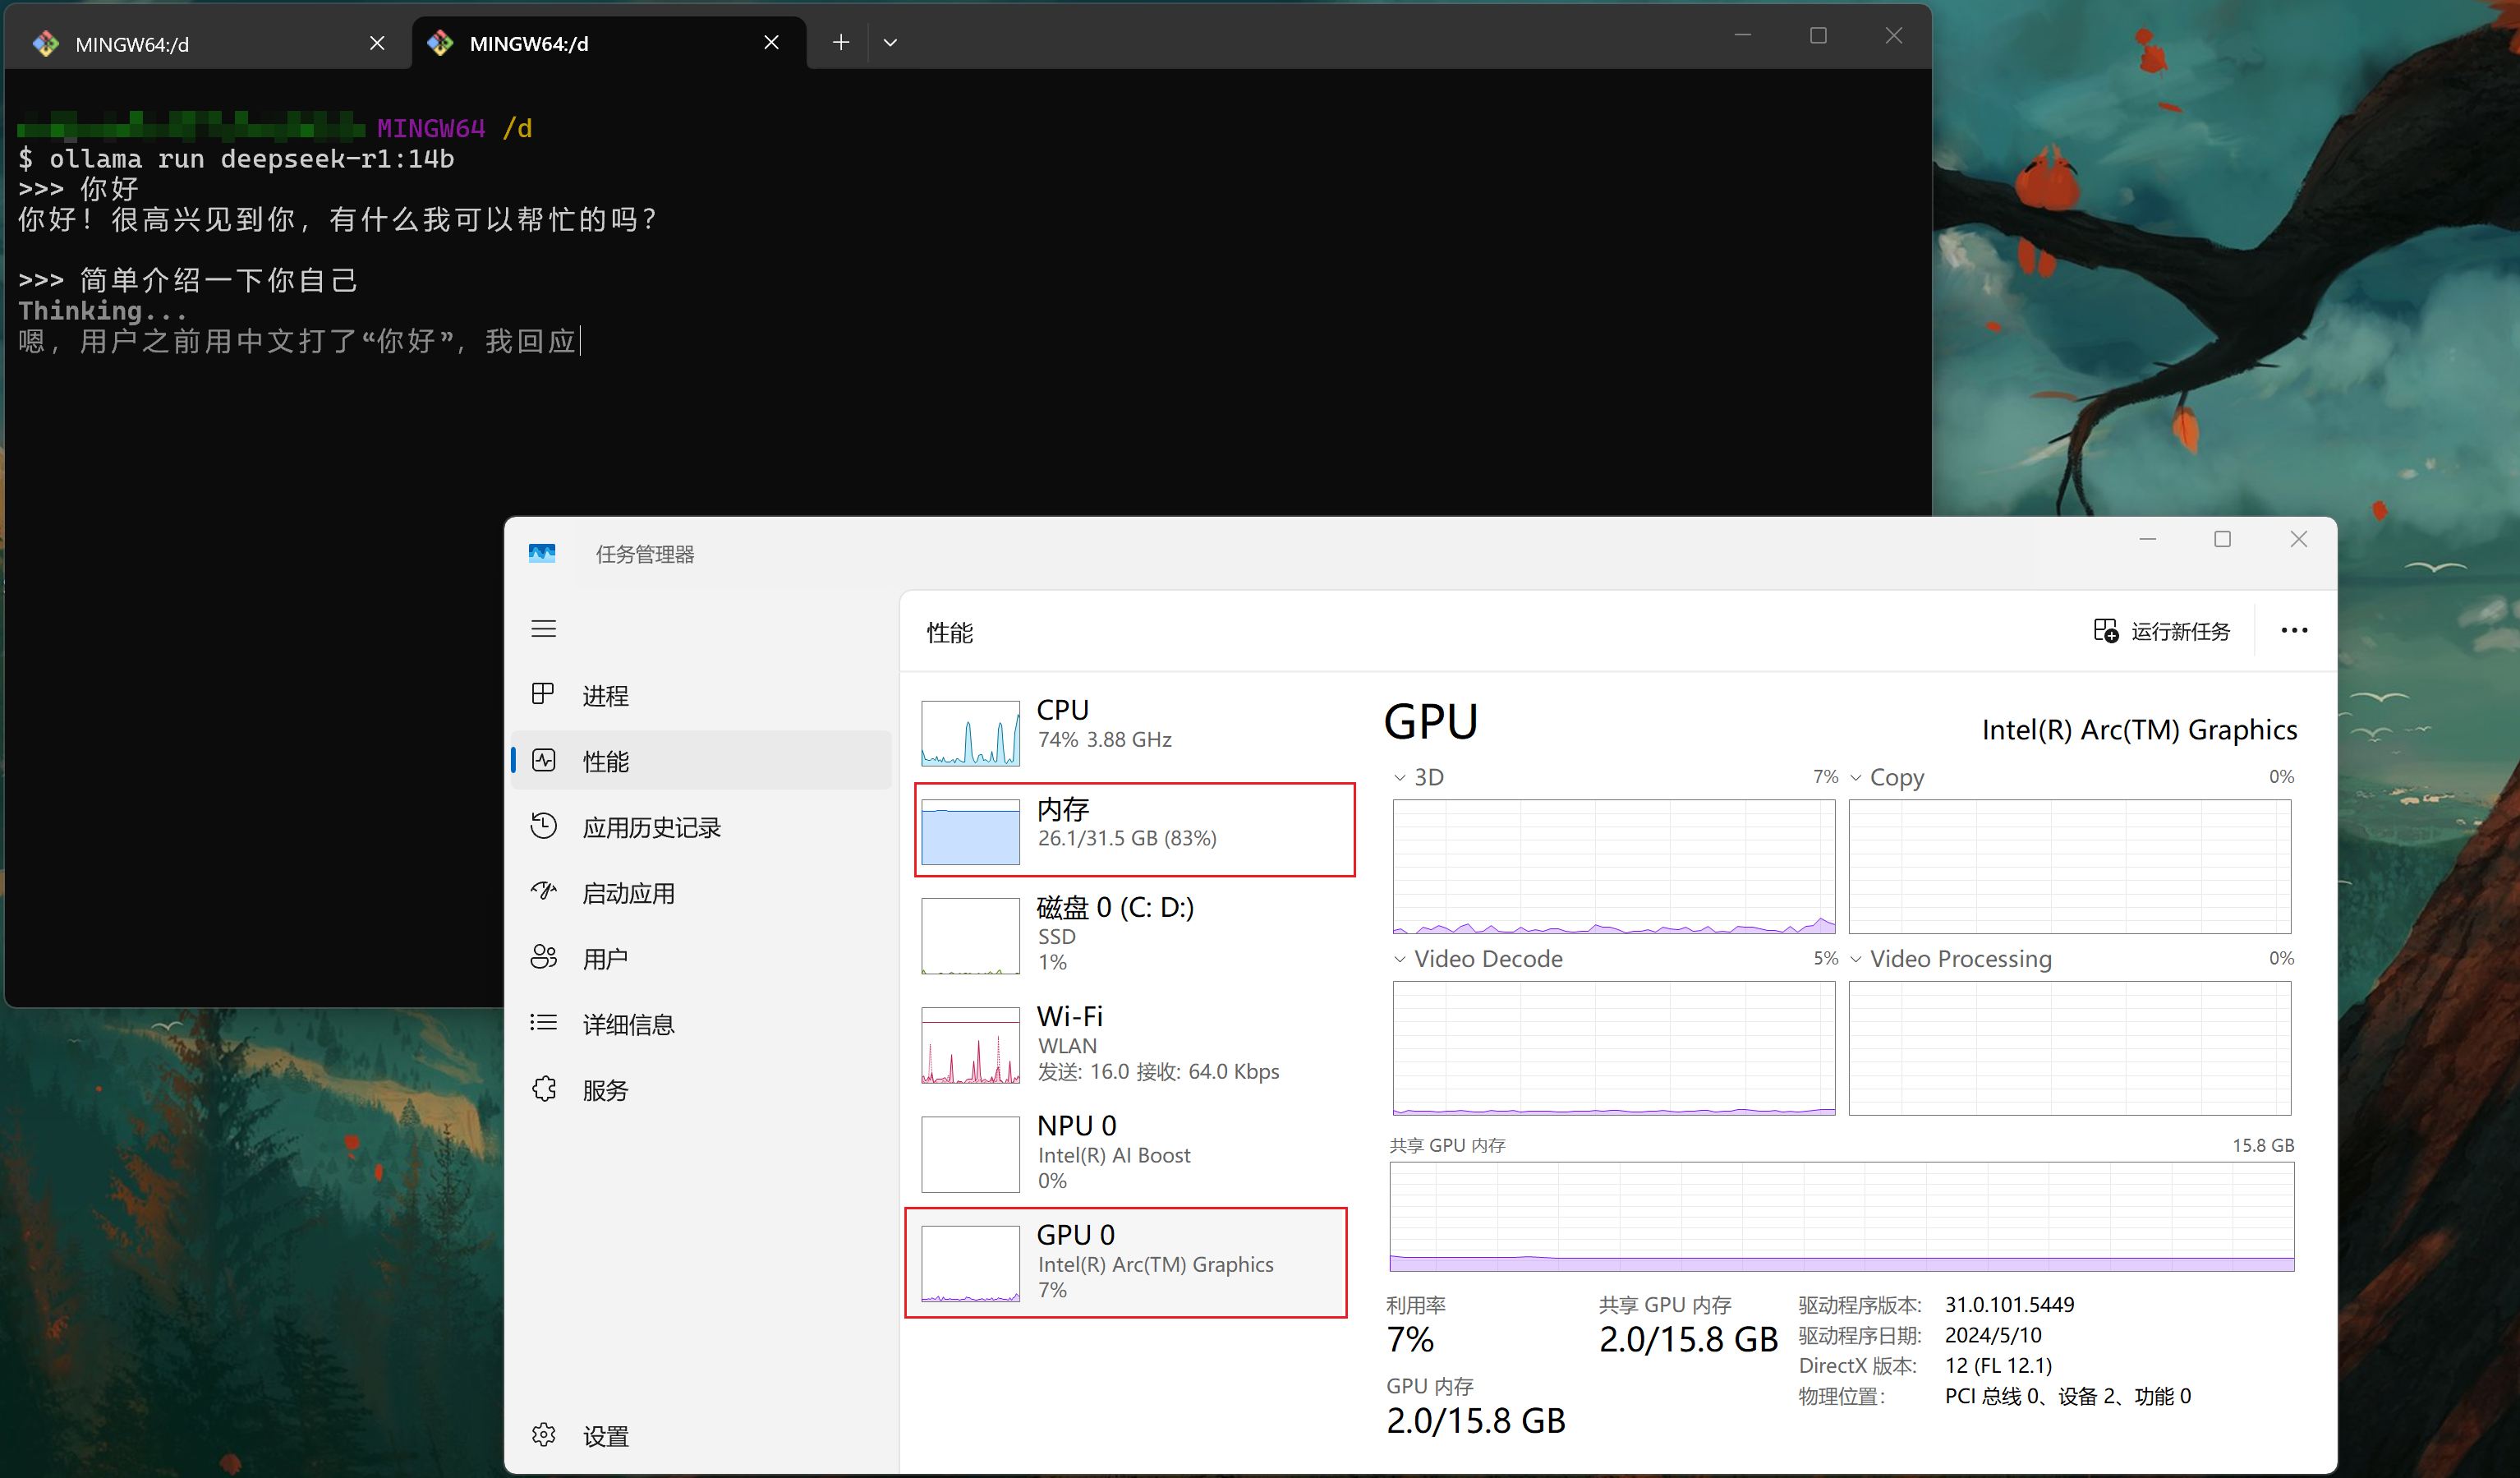
第二种情况则更具迷惑性——加载deepseek-r1:14b这类大模型时,任务管理器显示GPU有约7%的占用率。这个数值很容易让人误以为GPU在工作,但实际测试发现:
- 这7%的占用主要来自系统基础进程
- 模型推理时GPU频率和功耗未见明显波动
- 相同模型在正确配置环境下GPU占用应达到60%以上
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 技术背景分析
要理解这个问题的本质,需要先了解Ollama的硬件加速机制。Ollama默认使用CUDA进行NVIDIA显卡加速,对Intel显卡的支持则经历了几个发展阶段:
- 早期方案:需要单独下载英特尔优化版Ollama,这个版本维护滞后(通常比主版本晚2-3个迭代)
- 转折点:0.12.11版本开始通过Vulkan API原生支持Intel GPU
- 现状:最新稳定版(如v0.17.5)已内置完善的Vulkan支持
Vulkan作为跨平台图形API,其优势在于:
- 统一的驱动接口标准
- 更低的CPU开销
- 更好的多GPU支持
- 显式内存管理
但默认情况下Ollama不会主动启用Vulkan后端,这就是为什么需要手动配置环境变量。
3. 完整解决方案
3.1 环境准备
首先确认系统环境符合以下要求:
- 操作系统:Windows 10/11 64位(Linux/macOS方案略有不同)
- 显卡驱动:安装最新版Intel Arc显卡驱