
 weixin_29053383
1. Transformer架构的革命性突破
2017年Google提出的Transformer架构彻底改变了自然语言处理的游戏规则。作为一名长期从事NLP研究的工程师,我至今仍记得第一次实现自注意力机制时的震撼——它完美解决了困扰我们多年的序列建模难题。
1.1 自注意力机制深度解析
自注意力机制的核心在于动态计算序列中每个位置与其他位置的关联权重。想象你在阅读一篇文章时,大脑会不自觉地在当前词语与前后文之间建立联系——这正是自注意力要模拟的认知过程。
python复制import torch
import torch.nn as nn
import math

class SelfAttention(nn.Module):
    def __init__(self, d_model=512, n_heads=8):
        super().__init__()
        assert d_model % n_heads == 0
        self.d_k = d_model // n_heads

        # 线性变换矩阵
        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.W_o = nn.Linear(d_model, d_model)

    def forward(self, x, mask=None):
        batch_size, seq_len, d_model = x.shape

        # 计算Q,K,V (B,S,D) -> (B,S,D)
        Q = self.W_q(x)
        K = self.W_k(x)
        V = self.W_v(x)

        # 多头拆分 (B,S,D) -> (B,H,S,D/H)
        Q = Q.view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        K = K.view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)
        V = V.view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2)

        # 注意力分数 (B,H,S,S)
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)
        attn = torch.softmax(scores, dim=-1)

        # 上下文向量 (B,H,S,D/H) -> (B,S,D)
        context = torch.matmul(attn, V)
        context = context.transpose(1, 2).contiguous()
        context = context.view(batch_size, -1, d_model)
        return self.W_o(context)
这段代码实现了几个关键设计:
- 多头机制:将特征空间分割到多个子空间,允许模型在不同表示子空间中学习不同方面的关系
- 缩放因子:1/√d_k 防止点积结果过大导致softmax梯度消失
- 掩码机制:处理变长序列和防止解码器看到未来信息
实际工程中需要注意:当序列长度超过1024时,原始自注意力的O(n²)复杂度会成为性能瓶颈。这时可以采用稀疏注意力、局部注意力等优化策略。
1.2 Transformer整体架构创新
完整的Transformer由编码器和解码器堆叠而成,每个层都包含几个核心组件:
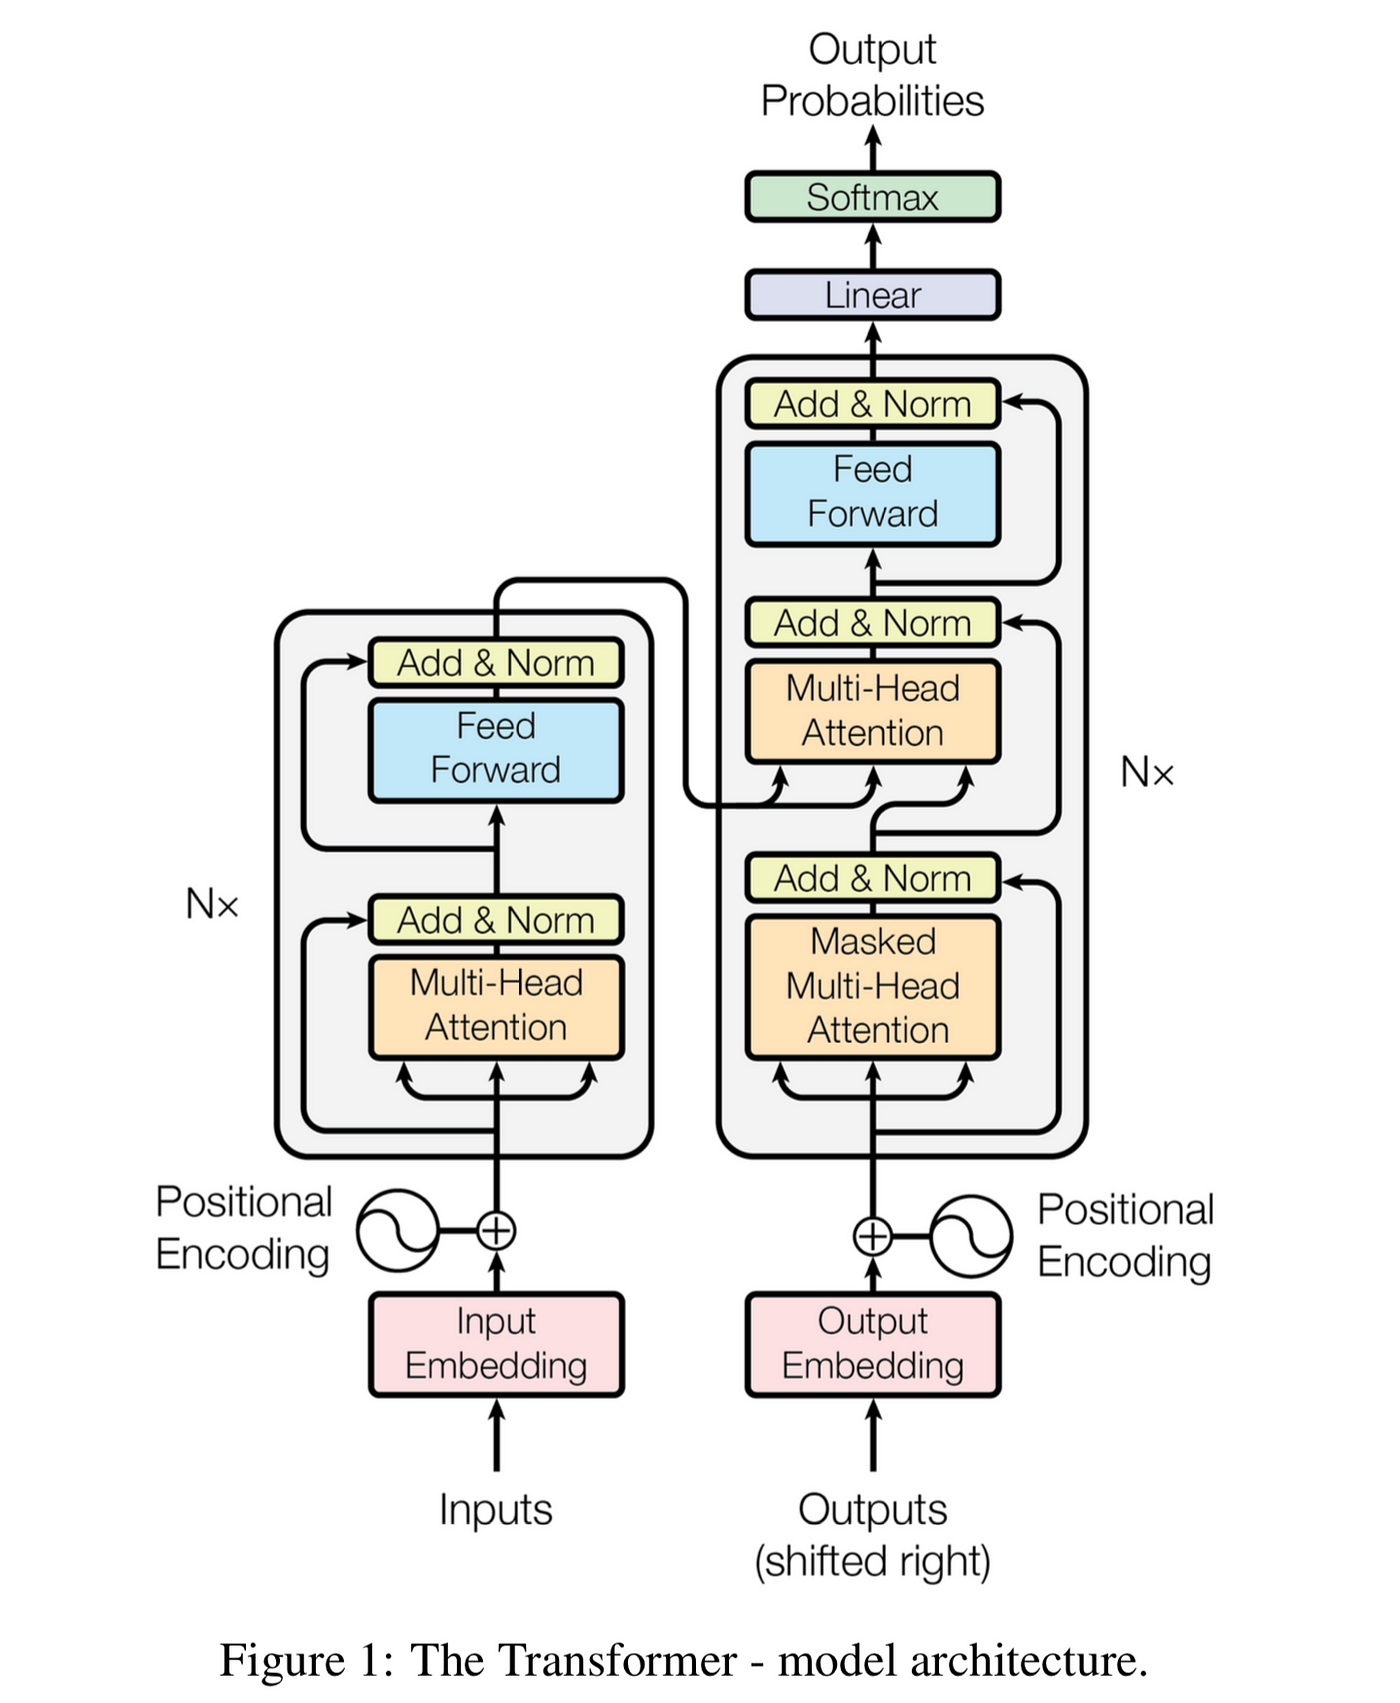
编码器层组成:
- 多头自注意力层
- 前馈神经网络(通常由两个全连接层组成,中间包含ReLU激活)
- 层归一化(LayerNorm)和残差连接
解码器特有机制:
- 带掩码的自注意力层(防止信息泄露)
- 编码器-解码器注意力层(建立源语言和目标语言的关联)
python复制class TransformerLayer(nn.Module):
    def __ini