
 时光里的沙漏
1. 引言:为什么需要这份术语指南?
作为一名长期深耕AI领域的技术从业者,我深刻理解初学者面对大模型技术栈时的那种无力感。记得2017年第一次接触Transformer论文时,光是理解"自注意力"这个概念就花了我整整三天时间。如今这个领域每天都有新术语涌现,像MoE、DPO、RAG这些缩写词,对新人来说简直就是天书。
这份指南的诞生源于我在技术社区答疑时的真实经历。过去半年里,我整理了超过200个关于大模型术语的提问,发现80%的困惑都集中在相同的基础概念上。比如:
- "多头注意力到底有几个头?"
- "LoRA和Adapter有什么区别?"
- "RLHF和DPO哪个更适合我的场景?"
这些问题背后反映的是一个更本质的需求:从业者需要一张清晰的"技术地图",既能快速定位概念定义,又能理解不同技术之间的关系。这正是本文试图解决的问题——不是简单的术语列表,而是一个有层次、有连接的知识网络。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 基础架构篇
2.1 Transformer:大模型的基石
2.1.1 架构全景图
Transformer的核心创新在于完全摒弃了RNN的序列处理方式。想象一个国际会议现场:传统RNN就像依次发言的代表,必须等前一个人说完才能开口;而Transformer则像自由讨论环节,所有参会者可以同时关注其他人的发言内容。
这种并行性来自三个关键设计:
- 位置编码:给每个词注入位置信息(类似会议桌上的名牌)
- 自注意力机制:动态计算词与词之间的关联强度(就像根据讨论话题自动调整关注对象)
- 残差连接:确保信息可以跨层直达(如同保留原始发言记录)
python复制# Transformer编码器层的精简实现
class TransformerEncoderLayer(nn.Module):
    def __init__(self, d_model, nhead, dim_feedforward=2048, dropout=0.1):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, nhead)
        self.linear1 = nn.Linear(d_model, dim_feedforward)
        self.linear2 = nn.Linear(dim_feedforward, d_model)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, src):
        # 自注意力子层
        src2 = self.self_attn(src, src, src)
        src = src + self.dropout(src2)
        src = self.norm1(src)

        # 前馈子层
        src2 = self.linear2(self.dropout(F.relu(self.linear1(src))))
        src = src + self.dropout(src2)
        src = self.norm2(src)
        return src
2.1.2 位置编码的数学之美
传统序列模型依赖顺序处理,而Transformer通过位置编码注入序列信息。其设计精妙之处在于使用不同频率的正余弦函数:
$$
PE_{(pos,2i)} = \sin(pos/10000^{2i/d_{model}}) \
PE_{(pos,2i+1)} = \cos(pos/10000^{2i/d_{model}})
$$
这种编码方式具有两个关键特性:
- 相对位置感知:对任意固定偏移量k,PE(pos+k)可以表示为PE(pos)的线性函数
- 距离衰减:远距离位置的关联度自然降低,符合语言特性
技术细节:现代大模型如GPT-3实际使用可学习的位置编码,但原始Transformer的三角函数式设计仍然影响着后续改进方向。
2.2 注意力机制详解
2.2.1 缩放点积注意力的实现细节
注意力机制的核心公式看似简单:
$$
Attention(Q,K,V) = softmax(\frac{QK^T}{\sqrt{d_k}})V
$$
但其中隐藏着几个关键设计选择:
- 缩放因子:除以$\sqrt{d_k}$防止点积结果过大导致softmax饱和
- 掩码机制:解码器中使用三角掩码实现自回归特性
- 多头投影:不同的头学习不同的关注模式
python复制def scaled_dot_product_attention(q, k, v, mask=None):
    # 计算注意力分数 [batch, heads, seq_len, seq_len]
    matmul_qk = torch.matmul(q, k.transpose(-2, -1))

    # 缩放
    dk = k.size()[-1]
    scaled_attention_logits = matmul_qk / math.sqrt(dk)

    # 掩码(解码器使用)
    if mask is not None:
        scaled_attention_logits += (mask * -1e9)

    # softmax归一化
    attention_weights = F.softmax(scaled_attention_logits, dim=-1)

    # 加权求和
    output = torch.matmul(attention_weights, v)
    return output, attention_weights
2.2.2 注意力的可视化解读
下图展示了一个实际案例中注意力权重的分布情况。可以看到:
- "it"这个词高度关注"animal"
- "didnt"与"not"形成强关联
- 标点符号的注意力普遍较弱
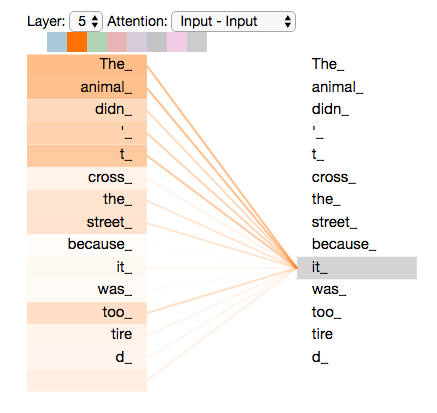
经验分享:调试模型时,观察注意力图是发现问题的有效手段。我曾通过异常注意力模式发现过数据标注错误。
2.3 多头注意力的工程实践
2.3.1 并行的秘密
多头注意力的实现精髓在于张量操作:
python复制class MultiHeadAttention(nn.Mod