
 漫步云间ing
1. 国产芯片大模型精度问题排查全景指南
在国产芯片上部署大模型时,精度下降问题往往让算法工程师们头疼不已。最近我在昇腾Atlas 200T A2 Box16上微调InterLM2-102B模型时,就遇到了下游评测精度平均下降1%的情况,部分评测集甚至下降了2%。经过两周的深度排查,最终定位到两个关键问题:fused adamw优化器实现差异和rms_norm算子精度问题。下面我将完整分享这次排查的经验和方法论。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 问题排查基础准备
2.1 建立可靠的对照实验环境
精度排查的首要原则是:确保实验条件严格可控。我们设置了A100和A2的对照实验,除硬件不同外,其他条件完全一致:
- 随机种子固定:所有随机数在CPU上生成后分发到设备
- 禁用随机性算子:检查dropout等算子,确保p=0
- 数据一致性:使用相同数据集且保证加载顺序一致
- 通信确定性:设置关键环境变量
bash复制export HCCL_DETERMINISTIC=true
export LCCL_DETERMINISTIC=1
注意:NPU的reduce操作存在浮点累加顺序问题,这些环境变量能确保通信计算的确定性。
2.2 精度问题分类框架
根据经验,大模型精度问题通常来自三个方面:
| 问题类型 | 检查要点 | 排查工具 |
|---|---|---|
| PyTorch原生算子 | matmul, linear等基础算子 | ditorch算子对比工具 |
| 扩展算子 | rms_norm, flash-attention等 | 最小复现代码比对 |
| 通信算子 | all_reduce, reduce_scatter等 | fp32回退测试 |
3. 系统性排查实战
3.1 第一阶段:loss曲线分析
我们首先对比了A100和A2的loss曲线(微调2个epoch):
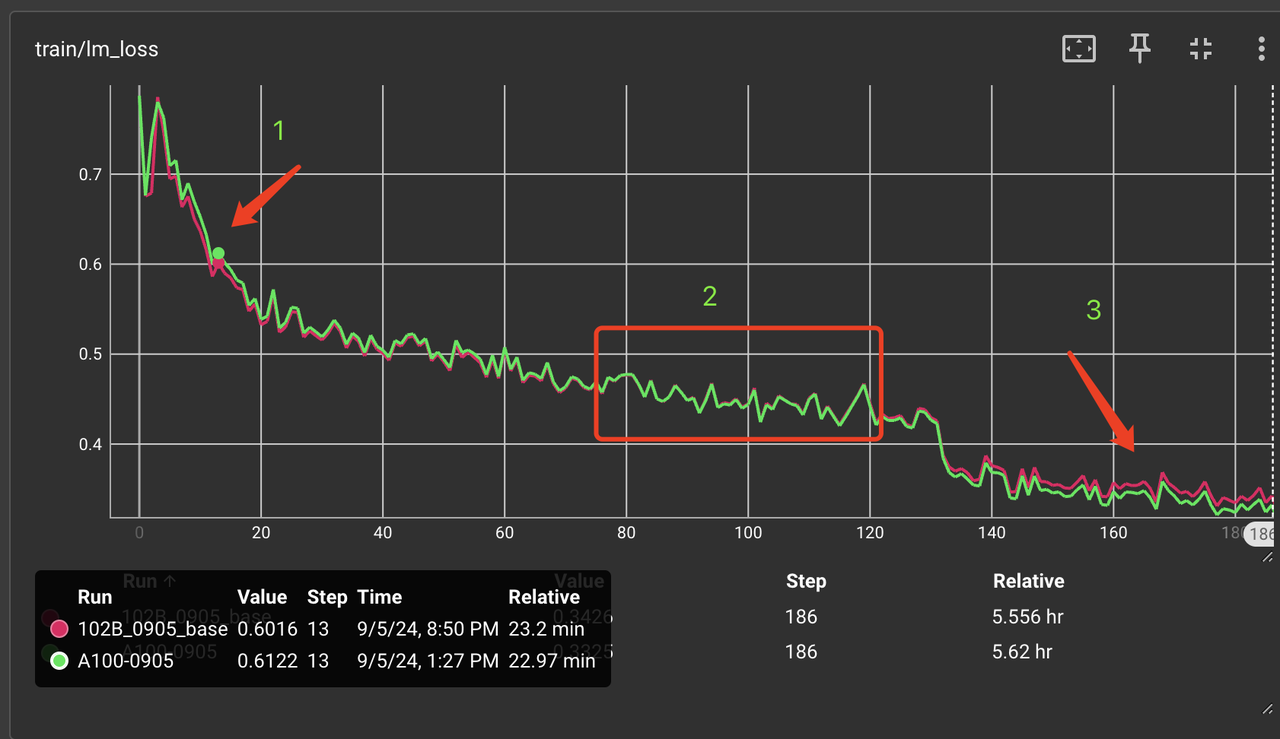
关键发现:
- 第1个epoch出现0.011的loss差异(相对误差1.8%)
- 第2个e